W mediach społecznościowych widać coraz więcej zrzutów ekranu w stylu „130 tokenów na sekundę na domowej karcie graficznej”. Robią wrażenie, ale nie odpowiadają na pytanie, które naprawdę ma znaczenie: czy to wystarczy do realnej pracy i ile kosztuje w porównaniu z chmurą. Zmierzyłem to na swoim sprzęcie. Poniżej metoda, wyniki i sposób liczenia, który da się przenieść na własną organizację.
Co właściwie mierzyć
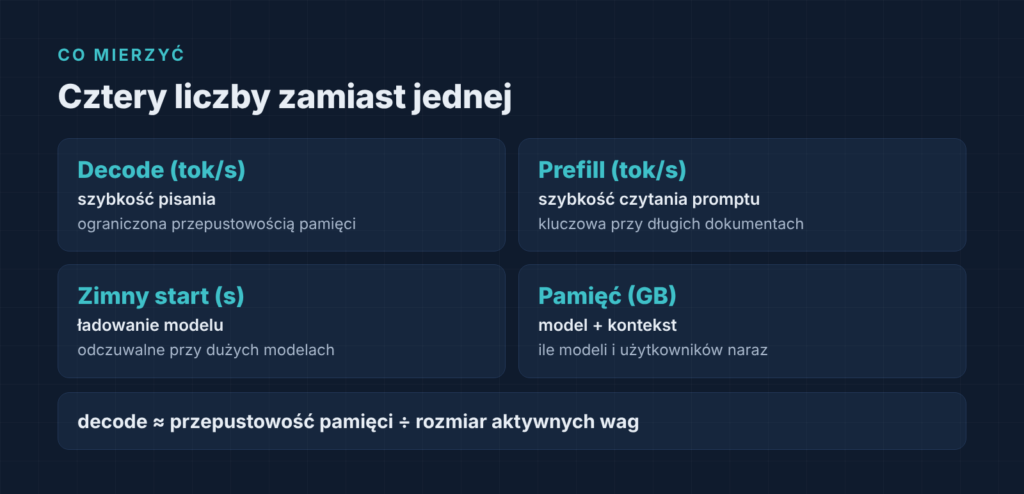
Zrzuty ekranu pokazują jedną liczbę, a do decyzji potrzebne są cztery:
- Szybkość generowania (tokeny na sekundę) – jak szybko model „pisze” odpowiedź. Dla skali: człowiek czyta 5–8 tokenów na sekundę, a od ok. 20 tok/s odpowiedź wydaje się płynna.
- Szybkość czytania promptu – jak szybko model przetwarza wejście: pytanie, historię rozmowy, załączone dokumenty. Przy pracy z umowami to często ważniejsze niż generowanie.
- Zimny start – ile trwa załadowanie modelu do pamięci, gdy nikt go przed chwilą nie używał.
- Pamięć – ile zajmuje model razem z kontekstem rozmowy. Od tego zależy, ile modeli zmieści się naraz i ilu użytkowników obsłuży jedna maszyna.
Jak mierzyłem
Pierwszy pomiar zrobiłem na szybko, ręcznie w terminalu. Kiedy go powtórzyłem, jeden z modeli wypadł o jedną czwartą wolniej. Dlatego zrobiłem to porządnie: każdy z siedmiu modeli dostał krótkie pytanie oraz dokument o długości ok. 9 tys. tokenów do streszczenia, każde zadanie trzy razy, a w tabeli jest mediana. Przed testem zamknąłem pozostałe aplikacje, a każde zapytanie miało unikalny początek, żeby silnik nie korzystał z zapamiętanego promptu. Ollama sama raportuje czasy poszczególnych etapów, więc nie trzeba żadnych dodatkowych narzędzi.
Sprzęt: MacBook Pro M5 Max, 128 GB wspólnej pamięci, Ollama 0.40, zasilacz, tryb wysokiej wydajności.
Wyniki
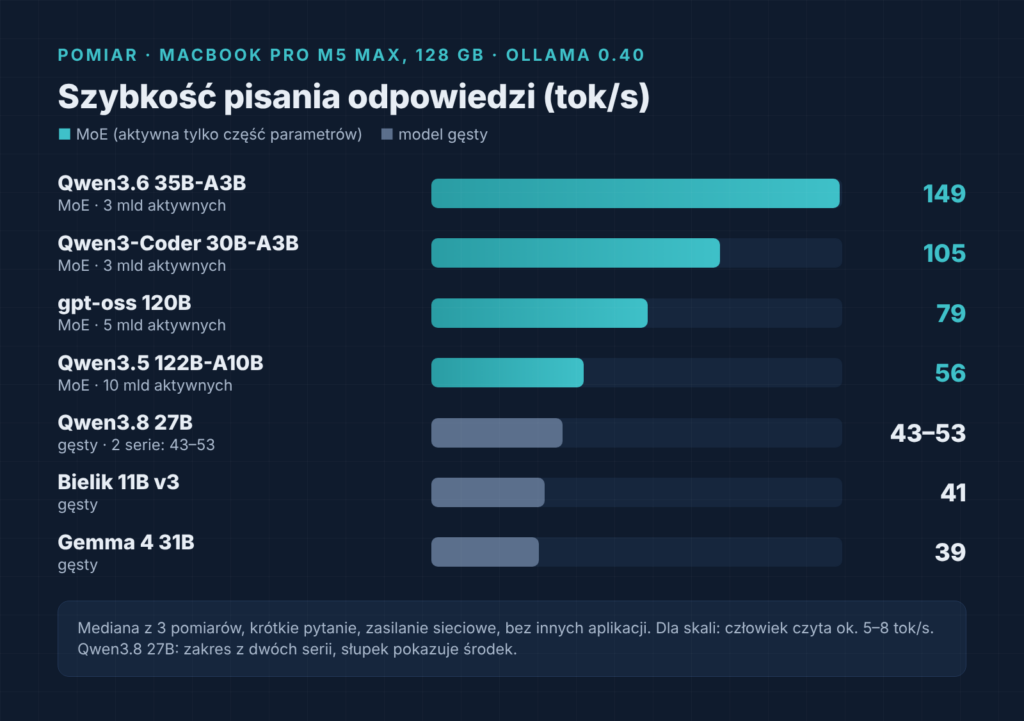
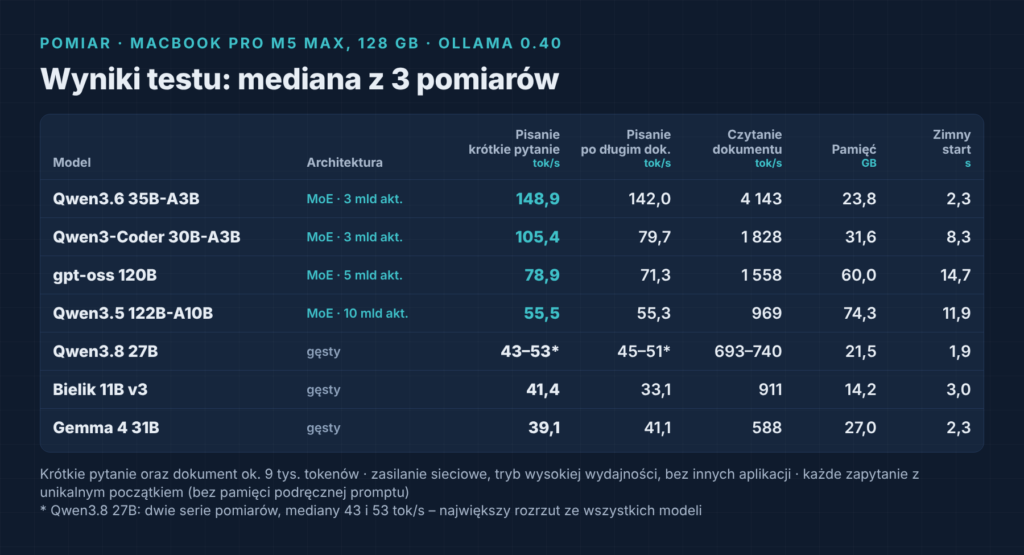
* Qwen3.8 27B: wyniki z dwóch serii pomiarów (mediany 43 i 53 tok/s). Ten model miał największy rozrzut, także w obrębie jednej serii (do 25%), przy identycznych warunkach.
Najszybszy model pisze ok. 149 tokenów na sekundę, czyli tyle, ile pokazują zrzuty z mocnych kart graficznych. Porównanie ma jednak sens tylko dla tego samego modelu – na gęstym modelu 27 mld karta z wysoką przepustowością pamięci będzie szybsza od Maca.
Ciekawsze jest co innego. Model 122 mld parametrów generuje co najmniej tak szybko (56 tok/s) jak gęsty model 27 mld (43–53 tok/s), a gpt-oss 120B (79 tok/s) wyraźnie szybciej. Długi dokument spowalnia generowanie w różnym stopniu: najszybszy model zwalnia o 5%, Qwen3-Coder i Bielik o 20–25%, a gęste modele 27–31 mld prawie wcale. Duże modele płacą za to zimnym startem – ładują się 12–15 s, mniejsze zwykle 2–3 s. Przy pracy ciągłej nie ma to znaczenia, przy przełączaniu modeli czuć to od razu.
U większości modeli trzy przebiegi różniły się o mniej niż 10%. Wyjątkiem był wspomniany Qwen3.8.
Skąd te różnice
Generowanie ogranicza przepustowość pamięci, a nie moc obliczeniowa. Przy każdym kolejnym słowie model musi odczytać z pamięci wszystkie wagi, które biorą udział w obliczeniu. W uproszczeniu: maksymalna szybkość ≈ przepustowość pamięci ÷ rozmiar aktywnych wag.
Stąd przewaga architektury MoE. Model, który przy każdym słowie uruchamia ok. 3 mld z 35 mld parametrów, czyta kilka razy mniej danych niż model gęsty podobnej wielkości. U mnie był ok. 3× szybszy od gęstego modelu 27 mld i 3,8× szybszy od Gemmy 4 (31 mld). Z tego samego powodu model 122 mld z ok. 10 mld aktywnych parametrów dotrzymuje kroku gęstemu 27 mld, choć ma ponad czterokrotnie więcej parametrów. Podobnie działa kwantyzacja: zapis wag w 4 bitach zamiast 16 zmniejsza model mniej więcej czterokrotnie i w podobnej skali przyspiesza generowanie, kosztem niewielkiej utraty jakości.
Czytanie promptu ogranicza z kolei moc obliczeniowa i tu przewagę mają duże karty graficzne. Dokument o długości ok. 9 tys. tokenów najszybszy model przeczytał w ok. 2 s, gęsta Gemma 4 w ok. 17 s. Przy pracy z umowami to różnica między odpowiedzią od razu a czekaniem.
Dwie rzeczy, o których łatwo zapomnieć. Kontekst kosztuje pamięć, więc „obsługuje milion tokenów” w specyfikacji nie znaczy, że na Waszym sprzęcie będzie to użyteczne. A ten sam polski tekst to dla jednych modeli 9 tys. tokenów, a dla Bielika ok. 16 tys. Modele z różnymi tokenizerami porównuje się czasem wykonania zadania, a nie samymi tokenami na sekundę.
Jak liczyć koszt: lokalnie czy w chmurze
Sam model kosztowy jest prosty. W chmurze płacicie za każde zapytanie (tokeny wejściowe i wyjściowe razy cena), więc koszt rośnie liniowo z użyciem, ale nie wymaga inwestycji. Lokalnie płacicie za sprzęt amortyzowany np. na 3 lata, energię i czas ludzi na utrzymanie, więc koszt jest prawie stały – do momentu, aż skończy się wydajność maszyny.
Przy małym wolumenie chmura prawie zawsze wygrywa. Lokalne przetwarzanie zaczyna się opłacać przy dużym, przewidywalnym wolumenie, np. przetwarzaniu wsadowym tysięcy dokumentów, albo wtedy, gdy o wyborze decyduje klasa danych, a nie cena.
Przed decyzją o sprzęcie odpowiedziałbym sobie na kilka pytań: jakie przypadki użycia i jaka klasa danych, ile zapytań dziennie i jak długie dokumenty, czy wystarczy model szybki, czy potrzebny jest duży, jaki czas odpowiedzi zaakceptują użytkownicy, ile pamięci trzeba na modele z kontekstem i zapasem, kto będzie utrzymywał środowisko i ile ten sam wolumen kosztowałby w chmurze. Jeden dzień pomiarów na stacji roboczej daje lepszą podstawę do decyzji niż tydzień czytania specyfikacji.
Jeśli liczyliście TCO lokalnych modeli wobec chmury na prawdziwym wolumenie, chętnie porównam wyniki i metodę – to pomiary z jednego laptopa, a nie laboratoryjny benchmark.
Seria „Lokalna AI w praktyce”
- Co się psuje, gdy AI wychodzi z prezentacji do prawdziwej pracy
- Suwerenna AI: środowisko AI bez wysyłania danych do chmury
- Ile naprawdę daje lokalne AI? Wydajność i koszt (ten artykuł)
- Jeden model to za mało: portfel modeli AI
- Jak AI może przejrzeć tysiące elementów i nie zabrać człowiekowi decyzji
- Mniejszy model, lepszy proces: trzy podejścia do tej samej selekcji
Zastanawiacie się, czy i jak wdrożyć AI w organizacji, w której dane nie mogą wyjść poza własną infrastrukturę? Porozmawiajmy – zobacz też zakres usług.