Demo AI działa zawsze. Kłopoty zaczynają się w drugim tygodniu, kiedy system ma pracować codziennie, na prawdziwych danych, bez autora siedzącego obok. Budując lokalne środowisko AI, zapisywałem każdą awarię. Co ciekawe, żadna nie wynikała z tego, że model był „za głupi”. Wszystkie siedziały w integracji, konfiguracji i operacjach – w miejscach, których na prezentacjach nie widać.
Każdą opisuję tak samo: objaw, przyczyna i zasada, którą z tego wyciągam. Szczegóły techniczne są moje, zasady pasują do każdego wdrożenia, także chmurowego.
1. Sprawny model, który odrzucał każde pytanie
Objaw: jeden z modeli w czacie na każde pytanie zwracał ten sam błąd o braku obsługi narzędzi. Uruchomiony bezpośrednio odpowiadał normalnie.
Przyczyna: interfejs czatu dokłada do każdego zapytania listę narzędzi, które model może wywołać. Silnik modeli sprawdza, czy szablon modelu je deklaruje, a jeśli nie, odrzuca całe zapytanie. Przełącznik w panelu aplikacji nic nie dał, bo problem siedział w definicji modelu.
Zasada: integracja to kontrakt. Dwa elementy, które osobno działają, razem mogą nie działać wcale, więc testy akceptacyjne robi się na całym łańcuchu.
2. Usługa, która startowała sama, z innymi ustawieniami
Objaw: wszystko działało, ale wolniej i z krótszym kontekstem, niż zakładała konfiguracja.
Przyczyna: aplikacja silnika modeli dopisała się do autostartu. Skrypt startowy widział, że silnik „jest uruchomiony”, i korzystał z instancji z domyślnymi parametrami. Moja konfiguracja była po prostu pomijana.
Zasada: konfiguracja, której nikt nie egzekwuje, jest sugestią. Pytanie „czy działa?” nie wystarcza – trzeba pytać, czy działa tak, jak to zaprojektowaliśmy.
3. Model, który działał tylko z internetem
Objaw: dyktowanie głosowe w trybie offline nie działało, choć model leżał na dysku i zajmował 3 GB.
Przyczyna: biblioteka pobierająca zapisała model w nowym formacie pamięci podręcznej, którego aplikacja offline nie umiała odczytać. Z internetem po cichu pobrałaby go jeszcze raz i nikt by się nie zorientował.
Zasada: testuj w docelowym trybie pracy, nie w wygodnym. Skoro system ma działać offline, testy też robi się offline.
4. Proces, który po cichu pomijał dane
Objaw: kilkugodzinny proces wsadowy przez kilkanaście minut wypisywał w logu tylko „błąd porównania” i szedł dalej.
Przyczyna: chwilę wcześniej zamknąłem aplikację, która wydawała mi się zbędna, a razem z nią zatrzymał się silnik modeli. Zauważyłem to przypadkiem, zaglądając do okna terminala: zamiast postępu kolumna identycznych komunikatów. Proces traktował brak połączenia jak błąd pojedynczego elementu i brał następny. Gdybym nie spojrzał, dokończyłby pracę z dziurawymi wynikami. Dziś przy braku silnika zatrzymuje się, mówi wprost, co się stało, i czeka.
Zasada: błąd jednego elementu to co innego niż awaria infrastruktury. W procesach AI cicha, zdegradowana praca bywa gorsza od głośnej awarii, bo wynik wygląda na poprawny.
5. Wznowienie, które dawało inne wyniki
Objaw: po przerwaniu i wznowieniu procesu część pracy wykonywała się od nowa, a wyniki różniły się od tych sprzed przerwy.
Przyczyna: proces losował kolejność porównań, a po wznowieniu losowanie wypadało inaczej, więc zapisane wyniki nie pasowały do nowych par. Teraz losowanie zależy tylko od danych wejściowych.
Zasada: procesy wsadowe AI muszą być deterministyczne i wznawialne. Przy pracy liczonej w godzinach przerwy zdarzą się na pewno: aktualizacja systemu, rozładowana bateria, zamknięta pokrywa laptopa.
6. Przeniesienie danych, które skasowało postęp
Objaw: po przeniesieniu zbioru danych na dysk zewnętrzny proces zaczął wszystko od początku.
Przyczyna: wyniki były powiązane z pełną ścieżką do pliku, więc nowa lokalizacja oznaczała dla systemu nowe pliki. Teraz wiążę je ze ścieżką względną wobec folderu źródłowego.
Zasada: stabilne identyfikatory to podstawa każdej architektury danych. Jeśli identyfikator zależy od miejsca przechowywania, każda migracja będzie bolała.
7. Dokumentacja, która rozjechała się z rzeczywistością w tydzień
Objaw: instrukcja opisywała parametry, których w konfiguracji już nie było, a lista modeli nie zgadzała się z tym, co faktycznie było zainstalowane.
Przyczyna: tempo zmian. Modele, parametry i ścieżki zmieniały się co kilka dni, a dokumentację pisałem ręcznie, „raz a dobrze”.
Zasada: w systemach AI dokumentację trzeba sprawdzać z systemem, najlepiej automatycznie. To samo dotyczy katalogu modeli i rejestru przypadków użycia.
Lista kontrolna przed uznaniem wdrożenia za gotowe
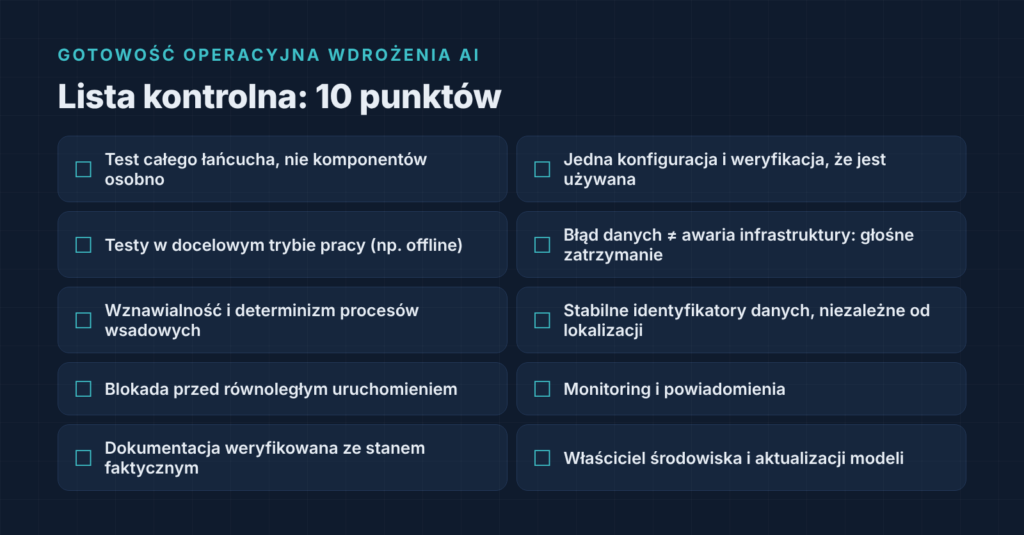
Z tych awarii powstała lista, którą przechodzę, zanim uznam rozwiązanie AI za gotowe:
- Test całego łańcucha: interfejs, silnik, model, narzędzia.
- Konfiguracja w jednym miejscu i sprawdzenie, że działający system faktycznie jej używa.
- Testy w docelowym trybie pracy (offline, docelowe uprawnienia, docelowy sprzęt).
- Rozróżnienie błędów danych i awarii infrastruktury, z głośnym zatrzymaniem w drugim przypadku.
- Wznawialność i determinizm procesów wsadowych.
- Stabilne identyfikatory danych, niezależne od lokalizacji.
- Blokada przed równoległym uruchomieniem tego samego procesu.
- Powiadomienia o zakończeniu i o awarii.
- Dokumentacja sprawdzana ze stanem faktycznym.
- Właściciel środowiska, który odpowiada za aktualizacje modeli i konfiguracji.
Gdzie naprawdę idzie praca
W moim PoC na oko 80% pracy pochłonęła „hydraulika”: integracje, konfiguracja, monitoring, tryby awaryjne, dokumentacja. Na wybór modelu poszła reszta. Jeśli plan AI w Waszej firmie ma budżet głównie na licencje, a niewiele na integrację i operacje, potraktowałbym to jako sygnał ostrzegawczy. W chmurze te problemy też są, tylko wyglądają inaczej.
Traktujcie to jako notatki z mojego laboratorium, a nie podręcznik – sam wciąż się tego uczę i na pewno nie zebrałem wszystkich pułapek.
Jeśli u Was przy wdrażaniu AI zepsuło się coś równie zaskakującego, chętnie porównam doświadczenia.
Seria „Lokalna AI w praktyce”
- Co się psuje, gdy AI wychodzi z prezentacji do prawdziwej pracy (ten artykuł)
- Suwerenna AI: środowisko AI bez wysyłania danych do chmury
- Ile naprawdę daje lokalne AI? Wydajność i koszt
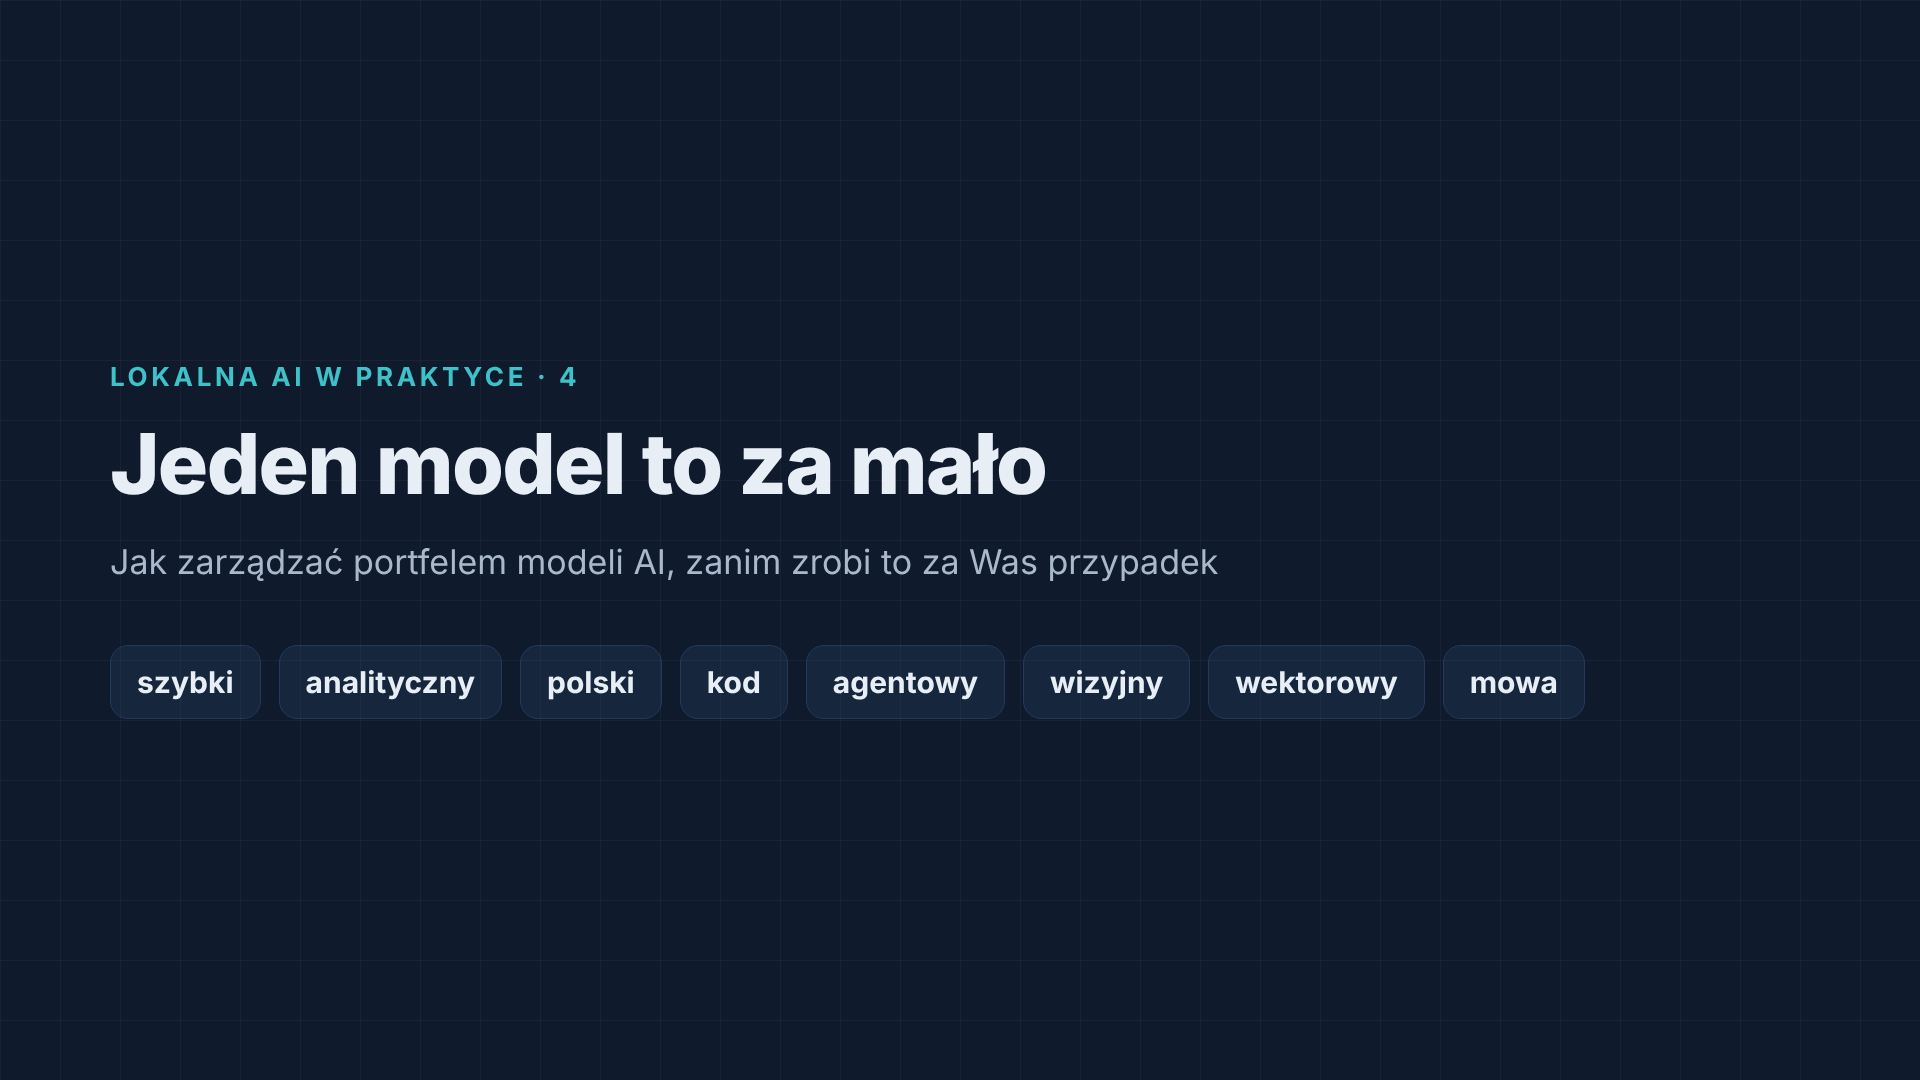
- Jeden model to za mało: portfel modeli AI
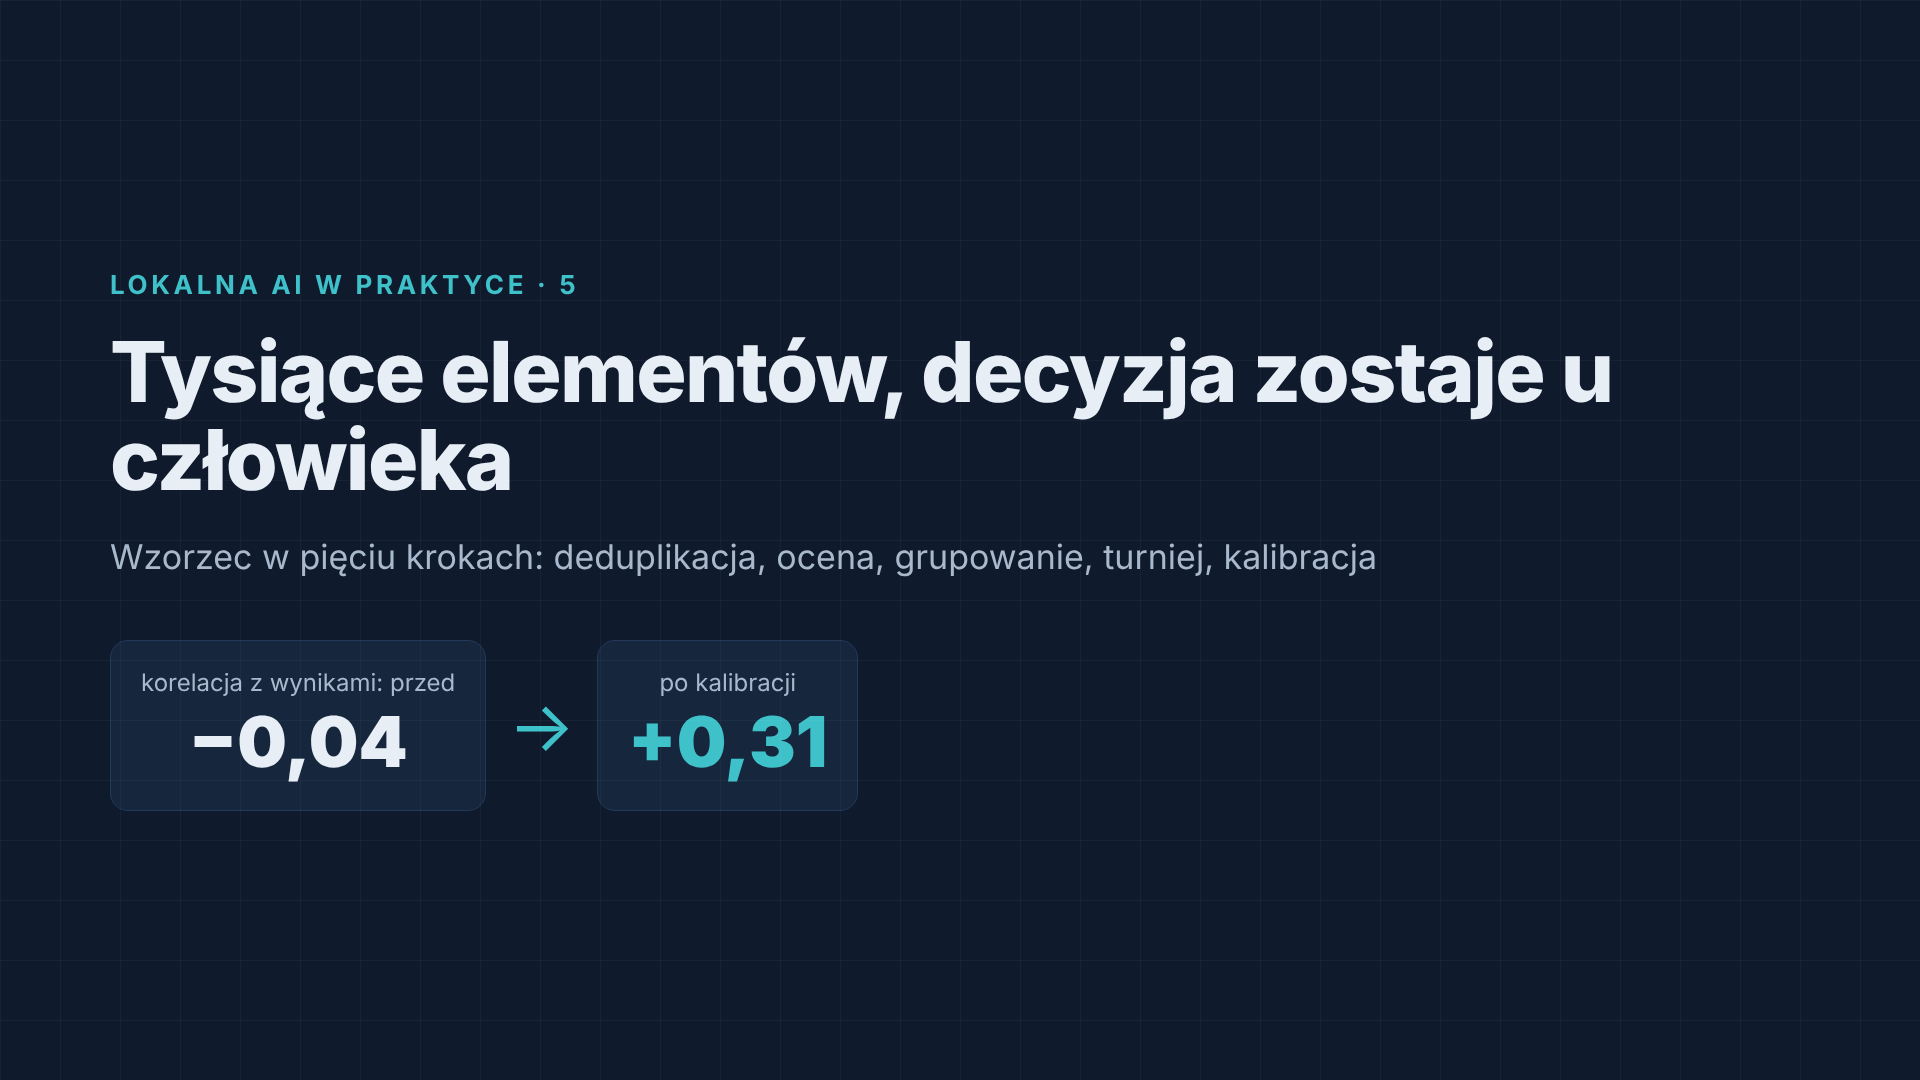
- Jak AI może przejrzeć tysiące elementów i nie zabrać człowiekowi decyzji
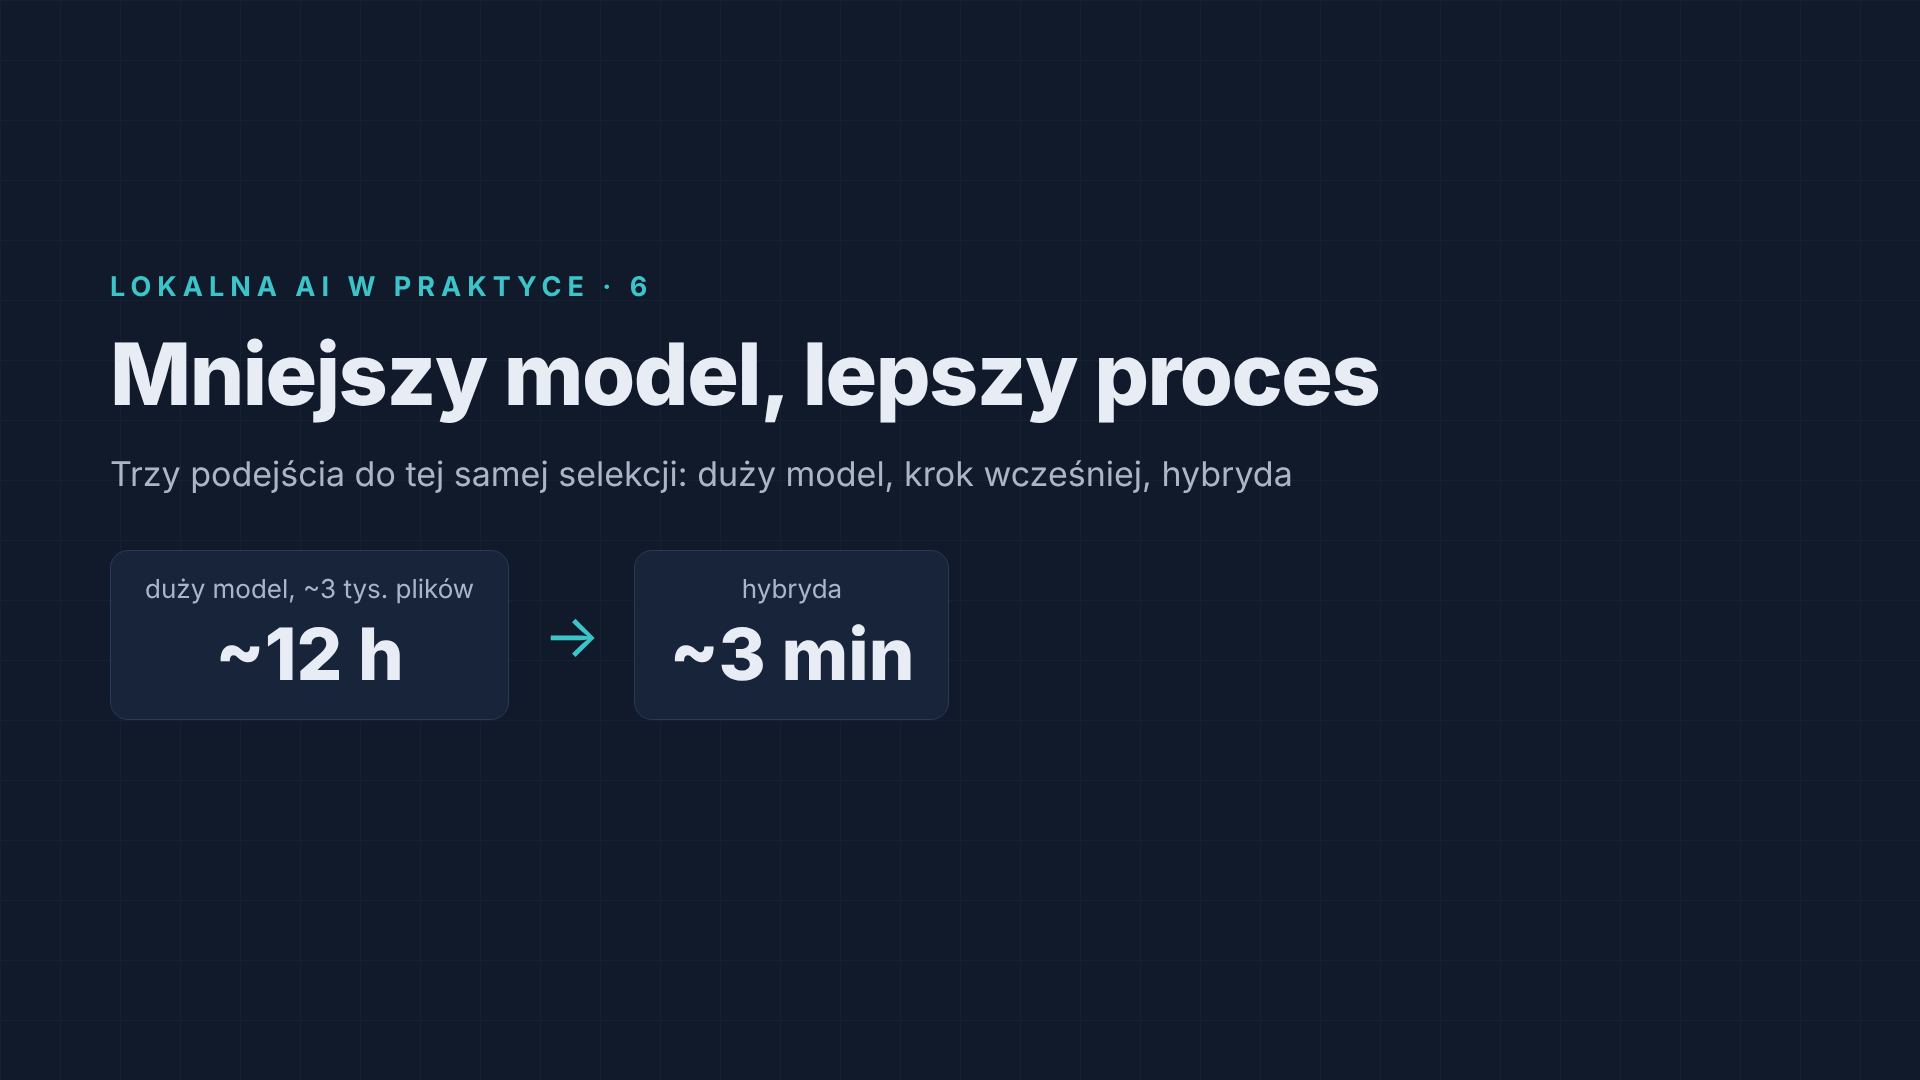
- Mniejszy model, lepszy proces: trzy podejścia do tej samej selekcji
Zastanawiacie się, czy i jak wdrożyć AI w organizacji, w której dane nie mogą wyjść poza własną infrastrukturę? Porozmawiajmy – zobacz też zakres usług.