W rozmowach o AI w firmach często padają naraz dwa zdania: „musimy to wdrożyć” i „nie możemy tam wrzucić naszych danych”. Postanowiłem sprawdzić, jak daleko da się zajść, gdy dane w ogóle nie opuszczają urządzenia. Opisuję architekturę, kilka decyzji, które okazały się ważniejsze, niż zakładałem, i to, jak przeniósłbym ten układ do organizacji.
Problem, którego nie widać w strategii AI
Zakaz używania publicznych czatów AI nie sprawia, że ludzie przestają z nich korzystać. Sprawia tylko, że robią to po cichu, na prywatnych kontach i telefonach. Fragmenty umów, dane klientów i wewnętrzne analizy trafiają do narzędzi, nad którymi organizacja nie ma kontroli. Klasyczne shadow IT, tylko szybsze.
Licencja enterprise w chmurze rozwiązuje część problemu. Nie pomaga tam, gdzie umowa z klientem, tajemnica zawodowa albo polityka bezpieczeństwa mówi wprost, że dane nie wychodzą poza naszą infrastrukturę. W finansach, administracji, kancelariach i doradztwie to codzienność.
Najpierw klasyfikacja danych, potem model
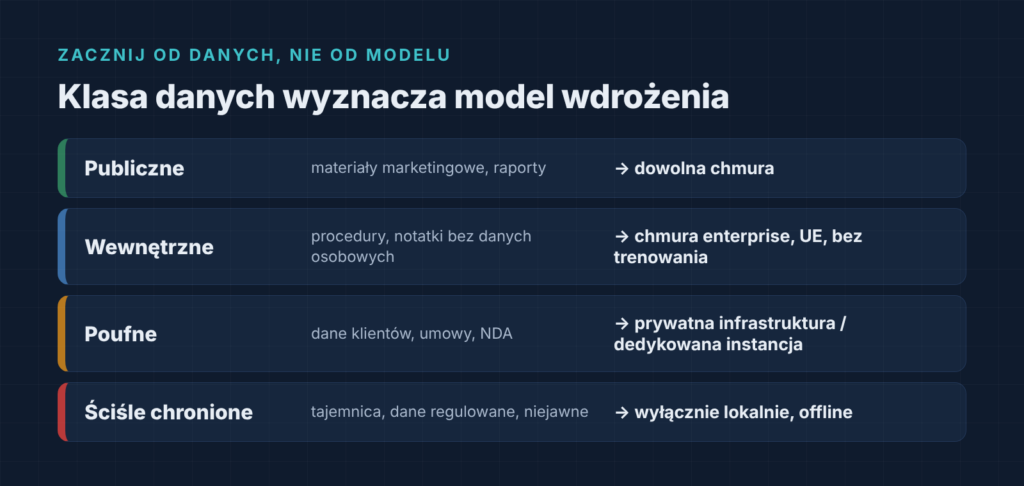
Dyskusja o AI zwykle zaczyna się od pytania, który model jest najlepszy. Jako architekt zaczynam gdzie indziej: jakie dane będą przetwarzane. Wystarczają mi cztery poziomy. Dane publiczne można wrzucać do dowolnych narzędzi chmurowych. Wewnętrzne, bez danych osobowych, mogą trafić do chmury w wersji enterprise, z umową, regionem w UE i wyłączonym trenowaniem na danych klienta. Poufne – dane klientów, umowy, dokumenty pod NDA – wymagają prywatnej infrastruktury albo dedykowanej instancji. Ściśle chronione, czyli tajemnica przedsiębiorstwa i dane regulowane, przetwarzam wyłącznie lokalnie, najlepiej offline.
Każdy przypadek użycia dostaje klasę danych, a klasa wyznacza dopuszczalny sposób wdrożenia. Taka tabela rozstrzyga więcej sporów niż miesiąc porównywania benchmarków. Mój PoC dotyczy dwóch ostatnich poziomów.
Jak to jest zbudowane
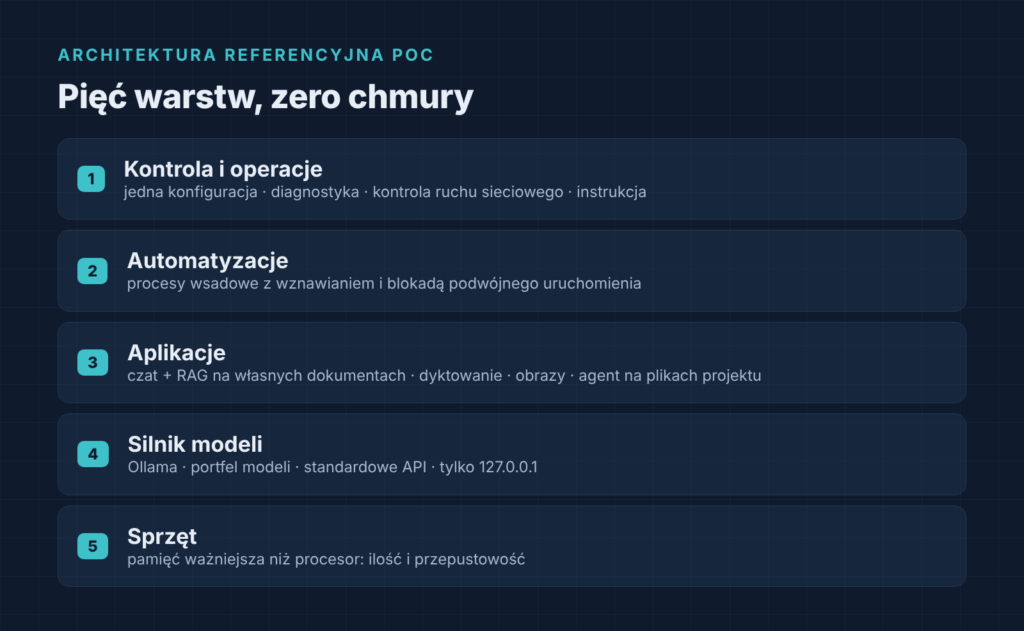
Całość działa na jednym laptopie (MacBook Pro, 128 GB wspólnej pamięci) i składa się wyłącznie z oprogramowania open source. Na dole jest sprzęt, w którym najważniejsza okazała się ilość i szybkość pamięci, a nie procesor – to ona decyduje, jak duży model się zmieści i jak szybko odpowie. Nad nim Ollama, która uruchamia lokalnie kilka modeli o różnych rolach, od szybkich po ponad 100-miliardowe, i udostępnia je przez standardowe API.
Z tego korzystają aplikacje. Open WebUI daje czat, wyszukiwanie we własnych dokumentach i dyktowanie przez lokalny model rozpoznawania mowy. Agent w terminalu czyta dokumenty projektu i przygotowuje raporty w Wordzie czy Excelu.
Decyzje, które zrobiły różnicę
Wszystkie usługi nasłuchują tylko na adresie lokalnym, więc nawet drugi komputer w tej samej sieci Wi-Fi nie ma do nich dostępu. Tryb offline jest domyślny: wyszukiwanie w internecie istnieje, ale włącza się je świadomie, osobnym przełącznikiem.
Najbardziej przekonała mnie zasada „weryfikacja zamiast deklaracji”. Osobny skrypt pokazuje, czy którykolwiek proces AI łączy się z czymś poza lokalną maszyną. Polityka „nic nie wychodzi”, której nie da się sprawdzić, pozostaje deklaracją.
Reszta to higiena. Wszystkie ustawienia są w jednym pliku tekstowym, a nie w panelach kilku aplikacji, więc każdą zmianę widać i da się ją odtworzyć. Całe środowisko, razem z modelami, instaluje się z paczki offline na komputerze, który nigdy nie widział internetu. Agent pracuje tylko w wybranym folderze projektu i o każdy zapis czy polecenie systemowe pyta. A oryginały są nienaruszalne: procesy AI zapisują kopie i wyniki obok źródła.
Regulacje w skrócie
To nie porada prawna, ale RODO (powierzenie przetwarzania, transfer poza EOG), DORA (chmurowa usługa AI jako zewnętrzny dostawca ICT) i AI Act warto mieć z tyłu głowy. Lokalne przetwarzanie upraszcza dwie pierwsze sprawy. AI Act ocenia przypadek użycia, a nie miejsce działania modelu, więc lokalne wdrożenie nie zwalnia z oceny ryzyka.
Czego lokalna AI nie załatwi
Lokalne modele są słabsze od najlepszych modeli chmurowych. Przy streszczeniach, analizie dokumentów, redakcji tekstów czy prostym kodzie różnica okazała się mniejsza, niż się spodziewałem. Przy złożonym, wieloetapowym rozumowaniu wciąż ją widać. Do tego dochodzi koszt sprzętu i utrzymanie: ktoś musi aktualizować modele, testować je i pilnować konfiguracji.
Jak przeniósłbym to do organizacji
Zacząłbym od inwentaryzacji: gdzie ludzie już dziś używają AI, także nieoficjalnie. Potem klasyfikacja przypadków użycia i pilot na jednej stacji dla danych poufnych – kilku użytkowników, kilka tygodni, pomiary jakości i czasu odpowiedzi na własnych zadaniach. Dopiero na tej podstawie decyzja o skali: stacje robocze dla specjalistów, serwer z GPU we własnej serwerowni z logowaniem SSO albo dedykowana instancja w prywatnej chmurze. Na koniec governance: katalog dopuszczonych modeli, zasady aktualizacji i właściciel platformy.
Laptop z mojego PoC nie jest docelową architekturą dla firmy. Pokazuje za to, że cały stos działa bez chmury i że próg wejścia jest dziś dużo niższy, niż się zwykle zakłada. Jeśli macie w organizacji dane, które nie mogą wyjść na zewnątrz, zacznijcie od tabeli klasyfikacji – zajmie jedno popołudnie i powie Wam, czy lokalna AI w ogóle jest u Was potrzebna.
Seria „Lokalna AI w praktyce”
- Co się psuje, gdy AI wychodzi z prezentacji do prawdziwej pracy
- Suwerenna AI: środowisko AI bez wysyłania danych do chmury (ten artykuł)
- Ile naprawdę daje lokalne AI? Wydajność i koszt
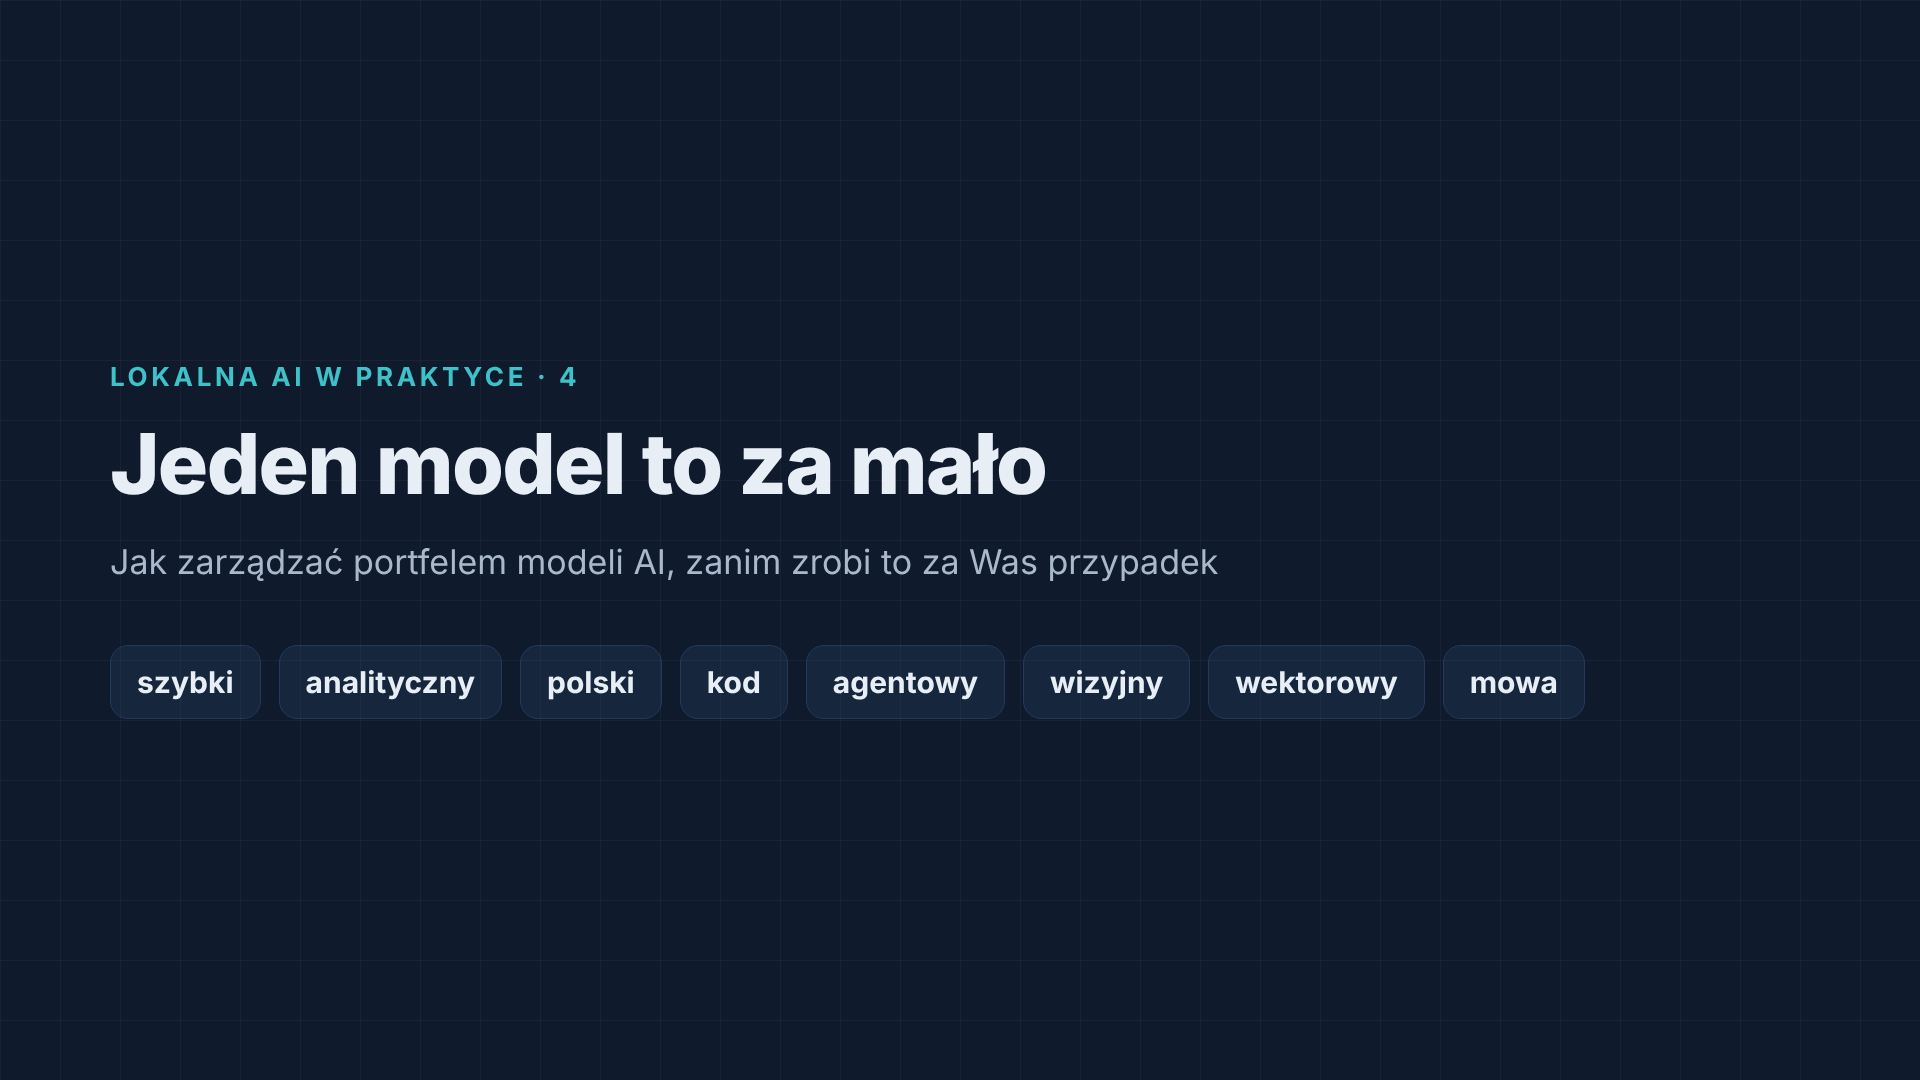
- Jeden model to za mało: portfel modeli AI
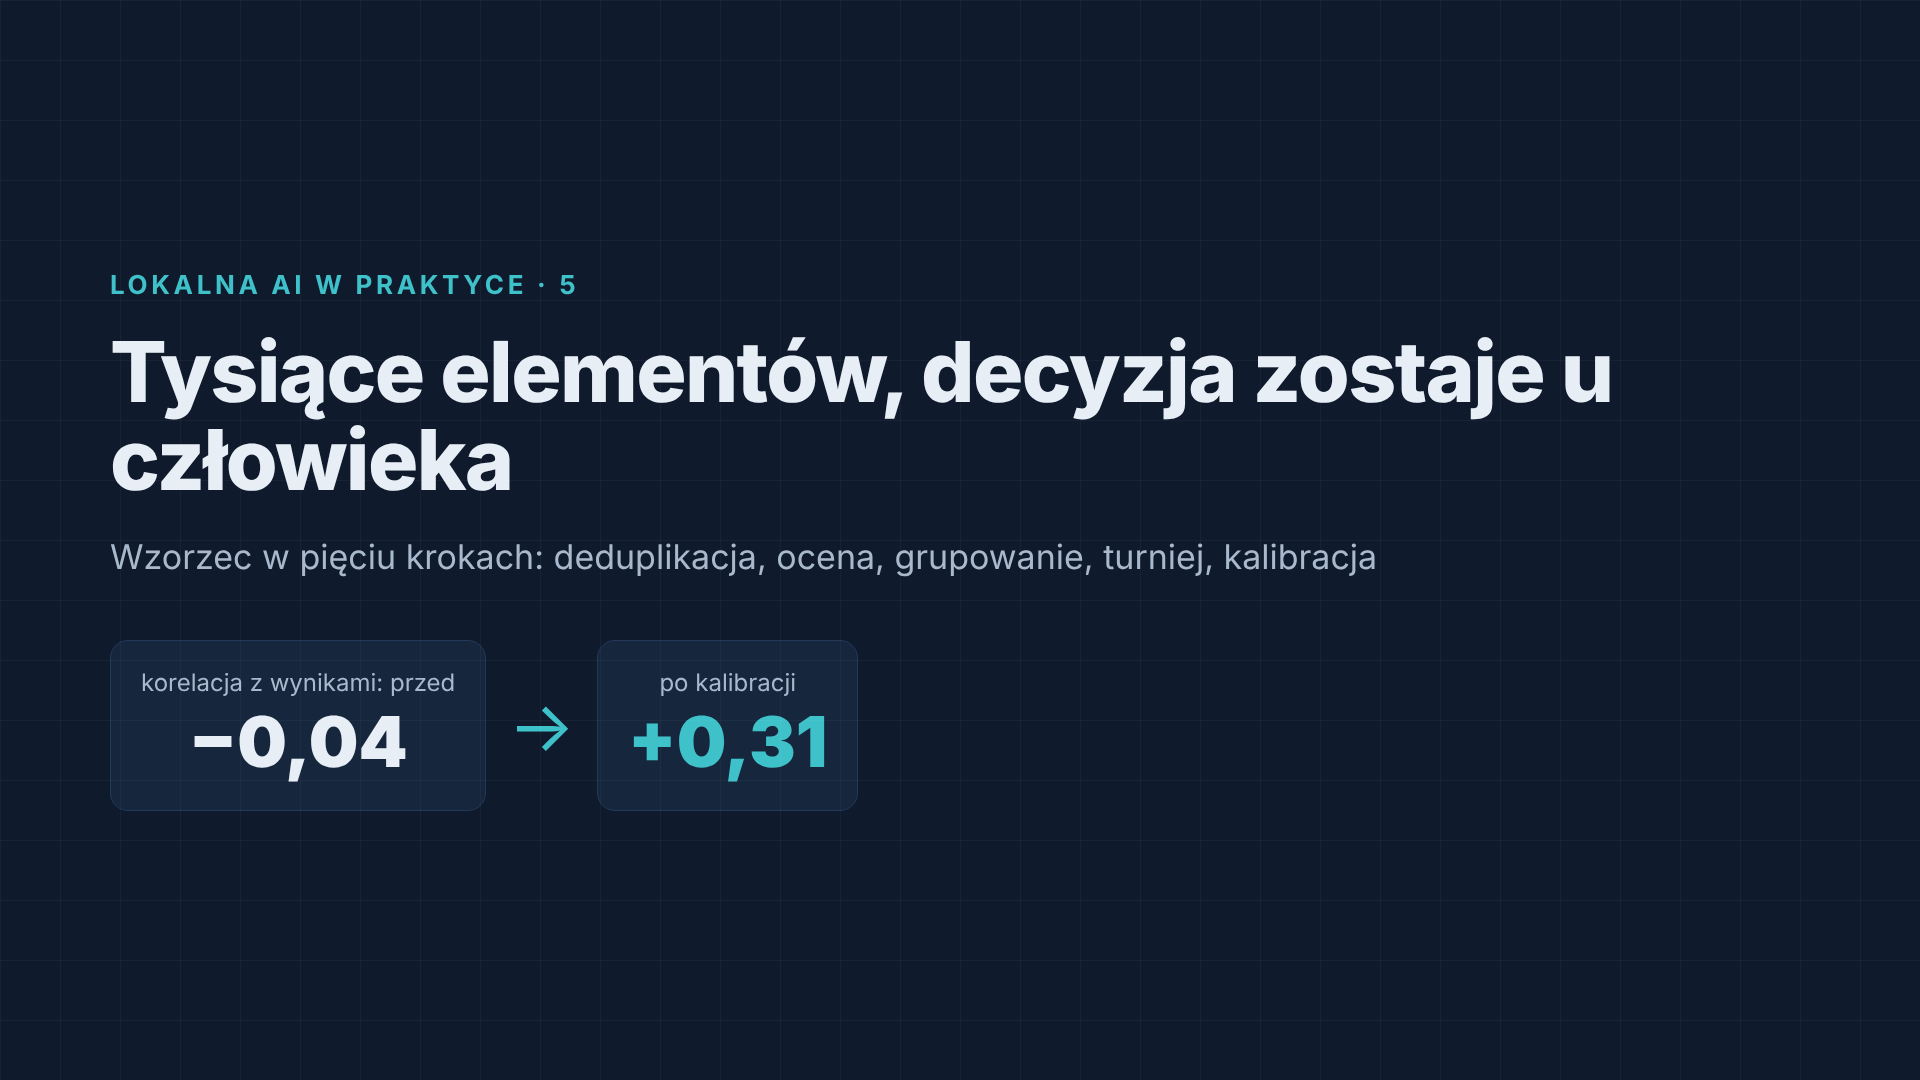
- Jak AI może przejrzeć tysiące elementów i nie zabrać człowiekowi decyzji
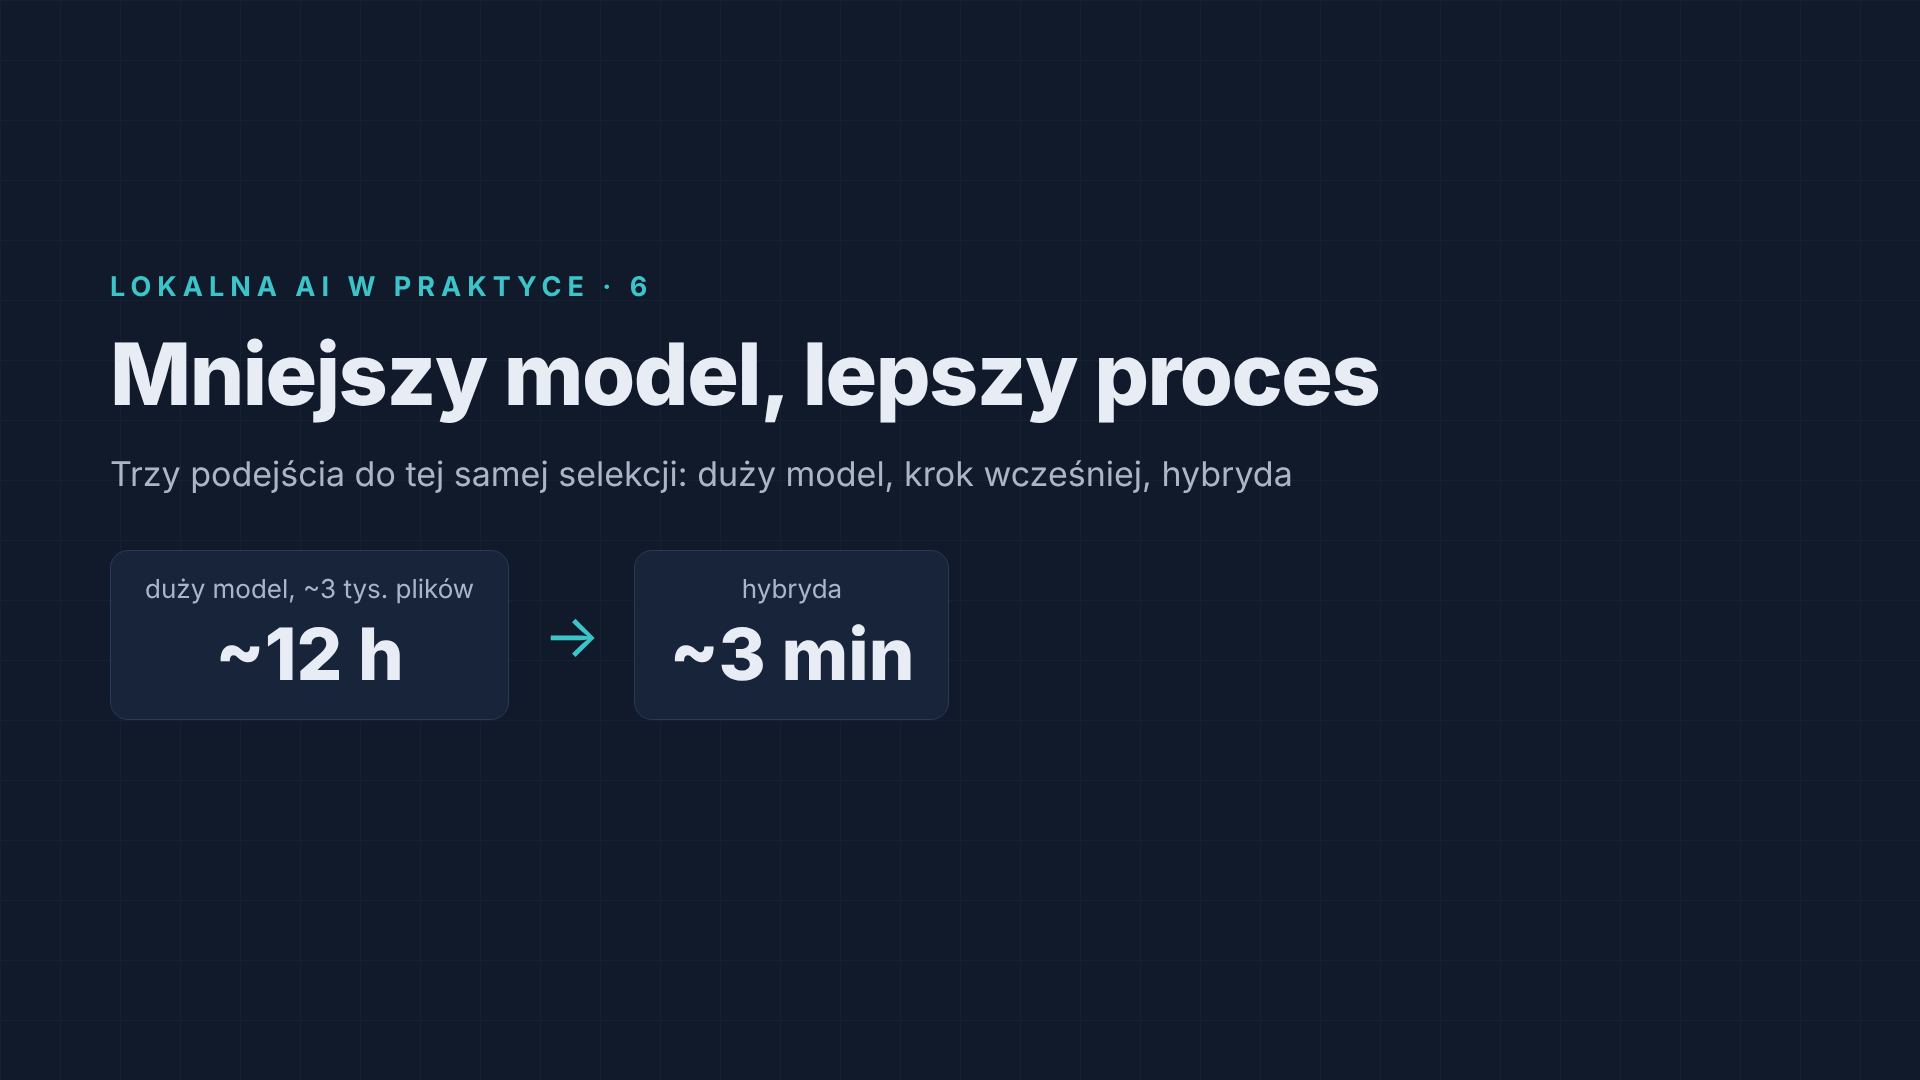
- Mniejszy model, lepszy proces: trzy podejścia do tej samej selekcji
Zastanawiacie się, czy i jak wdrożyć AI w organizacji, w której dane nie mogą wyjść poza własną infrastrukturę? Porozmawiajmy – zobacz też zakres usług.