Naturalny odruch to wybrać „ten jeden model” i załatwiać nim wszystko. U mnie, w lokalnym środowisku AI, pracuje dziś kilkanaście modeli. Brzmi jak przesada, ale wynika z prostej obserwacji: żaden model nie robi wszystkiego dobrze. Piszę o rolach w takim portfelu, o kryteriach wyboru, o tym, kto decyduje, który model odpowie, i o katalogu modeli, który prowadzi się jak katalog systemów.
Dlaczego jeden model nie wystarcza
W chmurze łatwo to przeoczyć, bo za jedną marką czatu i tak działa kilka modeli, a dostawca sam decyduje, który obsłuży pytanie. Gdy uruchamiasz modele u siebie, ta decyzja przechodzi na Ciebie. I szybko się okazuje, że żaden nie jest jednocześnie najszybszy, najlepszy w analizie, najlepszy po polsku, dobry w kodzie i zdolny czytać obrazy.
Role w portfelu
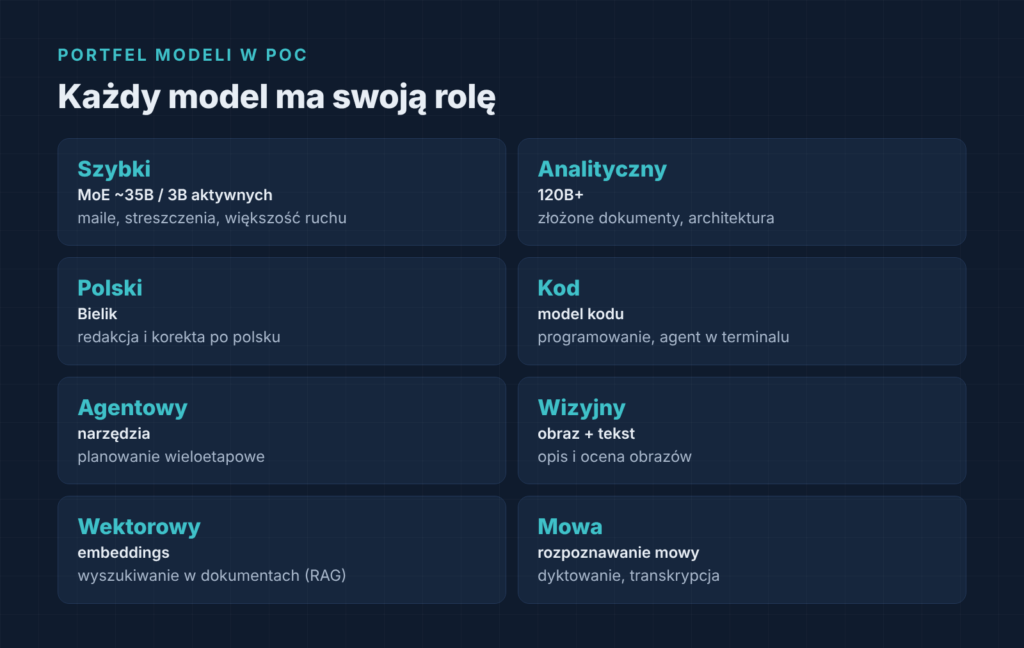
Większość ruchu obsługuje u mnie model szybki w architekturze MoE: ok. 35 mld parametrów, z których przy każdym słowie pracują tylko 3 mld. Odpowiada niemal od razu. Po model analityczny, ponad 120-miliardowy, sięgam przy złożonych dokumentach i dłuższym rozumowaniu. Polszczyzną zajmuje się Bielik od SpeakLeash, a do tego dochodzą modele do kodu, do pracy z narzędziami, do obrazów, do wyszukiwania w dokumentach i do rozpoznawania mowy.
Jak wybierać modele
Rankingi publiczne są dobrym punktem startu, ale decyzję podejmuje się na kryteriach z własnego kontekstu:
- Jakość w Waszym zadaniu, na Waszych dokumentach, a nie w ogólnym rankingu.
- Język. Model świetny po angielsku pisze po polsku poprawnie, ale sztywno – przy tekstach dla klientów to widać.
- Długość kontekstu, czyli ile tekstu model weźmie pod uwagę naraz. Przy umowach i dokumentacji przetargowej bywa twardym ograniczeniem.
- Możliwości techniczne: obrazy, wywoływanie narzędzi, tryb „myślenia”. Jeden z moich modeli odrzucał wszystkie zapytania z czatu tylko dlatego, że jego szablon nie deklarował obsługi narzędzi.
- Rozmiar: ile pamięci zajmuje i czy zmieści się obok innych.
- Licencja. Licencje modeli otwartych bardzo się różnią, część ma ograniczenia komercyjne. To temat dla działu prawnego, zanim model trafi do produkcji.
- Pochodzenie. Modele z oficjalnych źródeł i ich nieoficjalne przeróbki to różne poziomy ryzyka. W zadaniach biznesowych domyślnym wyborem powinny być wersje oficjalne.
Kto decyduje, który model odpowie
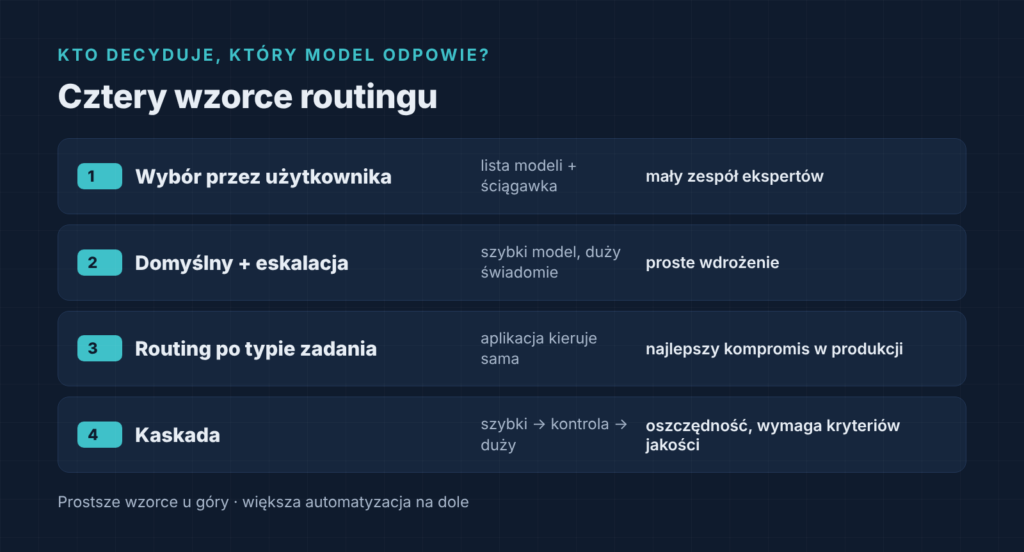
Skoro modeli jest kilka, ktoś musi wybierać. Znam cztery sposoby. Najprostszy to lista modeli w interfejsie i krótka ściągawka „do czego który” – dla małego zespołu ekspertów wystarcza. Drugi: wszyscy pracują na modelu szybkim, a po duży sięgają świadomie, gdy odpowiedź jest za słaba. Trzeci to routing po typie zadania – aplikacja sama kieruje korektę po polsku do modelu językowego, kod do modelu do kodu, a obraz do modelu wizyjnego. Czwarty to kaskada: model szybki odpowiada pierwszy, a gdy wynik nie przejdzie kontroli, zadanie trafia do dużego modelu. Oszczędza zasoby, ale wymaga dobrze zdefiniowanych kryteriów jakości.
Wdrożyłem u siebie wszystkie cztery i już pierwsze testy sporo mnie nauczyły. Poprosiłem o streszczenie artykułu, a router wysłał je do modelu do kodu, bo w tekście padło słowo „skrypty”. Wniosek: intencję trzeba rozpoznawać z pytania, a nie z treści załączonego dokumentu. Model do korekty z kolei zignorował instrukcję systemową i zamiast poprawić tekst, dopisał nowe sekcje. Pomogło dopiero umieszczenie polecenia w samej wiadomości – teraz poprawia, niczego nie dodaje i podaje listę zmian, choć ta lista bywa nieprecyzyjna.
Najważniejsza lekcja jest mniej techniczna. Reguły routingu decydują, gdzie trafiają dane i jakie zabezpieczenia obowiązują, więc powinny przechodzić taki sam przegląd jak reguły firewalla. Pomaga też przejrzystość: nad każdą odpowiedzią widać, który model odpowiedział i dlaczego.
Katalog modeli i własny zestaw testowy
Katalog modeli prowadziłbym tak jak katalog systemów IT: nazwa, wersja i źródło, rola i dopuszczone zadania, dopuszczone klasy danych, możliwości i ograniczenia, licencja, wymagania sprzętowe, właściciel oraz data i wynik ostatniego testu. U mnie okazał się niezbędny po kilku tygodniach, kiedy na dysku znalazłem model, którego nie było w żadnym spisie.
Ważniejszy od rankingów jest własny zestaw testowy: 20–50 zanonimizowanych zadań z codziennej pracy z opisem, jak wygląda dobra odpowiedź. Każdy nowy model przechodzi przez niego, zanim trafi do użytku. Modele zmieniają się szybciej niż jakakolwiek inna warstwa IT – w ciągu kilku tygodni wymieniłem mniej więcej połowę portfela – więc architektura musi to zakładać: standardowe API, jedna konfiguracja i żadnego przywiązywania aplikacji do nazwy konkretnego modelu.
Rozdzielenie odpowiedzialności, zarządzanie portfelem, testy akceptacyjne – architekci robią to od dawna. Teraz te same zasady trzeba zastosować do warstwy, która zmienia się co kilka tygodni, a router modeli dobrze pokazuje, że to sprawa governance w nie mniejszym stopniu niż techniki.
Seria „Lokalna AI w praktyce”
- Co się psuje, gdy AI wychodzi z prezentacji do prawdziwej pracy
- Suwerenna AI: środowisko AI bez wysyłania danych do chmury
- Ile naprawdę daje lokalne AI? Wydajność i koszt
- Jeden model to za mało: portfel modeli AI (ten artykuł)
- Jak AI może przejrzeć tysiące elementów i nie zabrać człowiekowi decyzji
- Mniejszy model, lepszy proces: trzy podejścia do tej samej selekcji
Zastanawiacie się, czy i jak wdrożyć AI w organizacji, w której dane nie mogą wyjść poza własną infrastrukturę? Porozmawiajmy – zobacz też zakres usług.