W wielu firmach jest ten sam problem: za dużo elementów do ręcznego przejrzenia. Zgłoszenia serwisowe, reklamacje, dokumenty, zdjęcia szkód, wnioski. Pierwszy odruch to „niech AI oceni każdy w skali 1–10”. Sprawdziłem to na zbiorze kilku tysięcy elementów i ocena punktowa okazała się najsłabszym ogniwem całego procesu. Opisuję, co zadziałało zamiast niej, z liczbami i pułapkami.
Dlaczego „oceń w skali 1–10” nie działa
Modele językowe, podobnie jak ludzie, słabo radzą sobie z ocenami bezwzględnymi. Ten sam element oceniony dwa razy potrafi dostać 6 i 8. Prawie wszystko ląduje w przedziale 6–8, więc trudno odróżnić bardzo dobre od dobrych. A model bez kontekstu ocenia według własnych wyobrażeń, a nie kryteriów organizacji.
Do tego dochodzi skala. Tysiące elementów to tysiące zapytań, czyli godziny pracy maszyny. Proces trzeba więc zaprojektować tak, żeby model robił tylko to, czego nie da się zrobić taniej.
Krok 1: deduplikacja bez AI
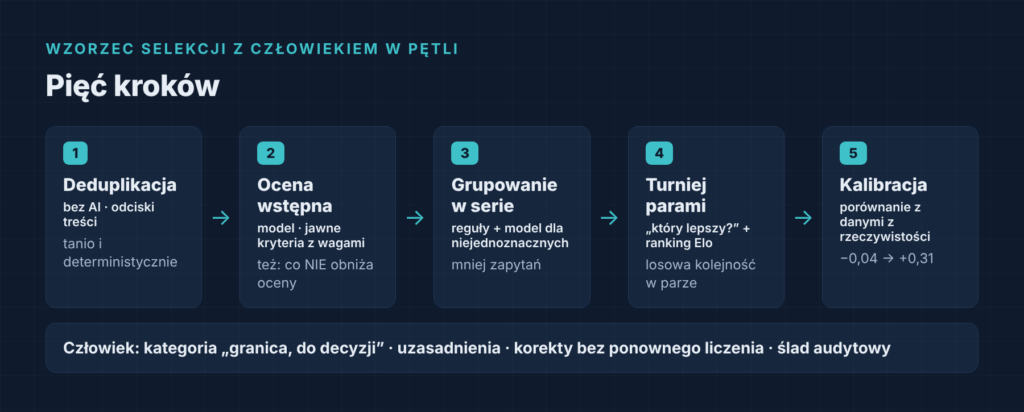
Zanim model cokolwiek zobaczy, usuwam duplikaty, czyli te same elementy zapisane kilka razy, w różnych kopiach i wersjach. Wystarczają klasyczne algorytmy porównywania treści, tzw. odciski odporne na drobne różnice, które działają w ułamku sekundy. Zostaje wersja najbardziej kompletna. Nie każdy problem potrzebuje modelu, a każdy element usunięty na tym etapie to jedno zapytanie mniej.
Krok 2: ocena według jawnych kryteriów
Model ocenia każdy element, ale nie ogólnym „oceń”. Dostaje opisane kryteria z wagami i kontekst – w moim przypadku opis tego, czego szukam. Zwraca nie tylko ocenę, ale też cechy elementu (kategorię, wady, typ) w ustalonym formacie, i te cechy przydają się później co najmniej tak samo jak sama ocena.
Jedna pułapka kosztowała mnie sporo czasu: w jednym z wariantów model systematycznie obniżał ocenę z powodu cechy, która według kryteriów nie miała znaczenia. Wyszło to dopiero przy kalibracji. Od tej pory piszę kryteria także w formie negatywnej: co nie jest powodem do obniżenia oceny.
Krok 3: grupowanie w serie
Elementy powiązane – ten sam przypadek, to samo zdarzenie, ten sam klient – trafiają do jednej grupy. Oczywiste przypadki rozstrzygają proste reguły, np. czas powstania i wspólne cechy elementów. Model rozstrzyga tylko przypadki pośrednie. Reguły tam, gdzie wystarczą, model tam, gdzie jest niejednoznacznie – mniej zapytań i bardziej przewidywalny wynik.
Krok 4: turniej porównań parami
Tu nastąpiła największa zmiana. Zamiast pytać „ile punktów?”, pytam „który z tych dwóch jest lepszy i dlaczego?”. Ranking w każdej grupie buduje system Elo, ten sam co w szachach: element zyskuje punkty, wygrywając z innym, tym więcej, im mocniejszy był przeciwnik. Kilka rund wystarcza, żeby wyłonić najlepszą część grupy.
Liczą się dwa szczegóły. Kolejność elementów w parze trzeba losować, bo modele mają skłonność do faworyzowania pierwszego (albo drugiego). A losowanie powinno zależeć od danych, a nie od czasu uruchomienia – wtedy po przerwie proces dostaje te same pary i zapisane wyniki dalej pasują.
Krok 5: kalibracja na prawdziwych wynikach
W tym miejscu łatwo uznać projekt za skończony. Moim zdaniem dopiero tu zaczyna się właściwa praca: porównanie ocen modelu z tym, jak elementy faktycznie sprawdziły się później, czyli z miarą rzeczywistego wyniku zebraną po fakcie.
Na początku korelacja ogólnej oceny modelu z rzeczywistymi wynikami wynosiła ok. −0,04, czyli praktycznie zero. System wyglądał mądrze, przekonująco uzasadniał oceny i nie przewidywał niczego. Po sprawdzeniu, które kryteria korelują z wynikami, i poprawieniu kryteriów oraz wag korelacja wzrosła do ok. +0,31. To zależność umiarkowana. Do wstępnego sortowania tysięcy elementów wystarcza, bo wyraźnie lepiej niż losowo pokazuje, gdzie patrzeć najpierw. Do automatycznych decyzji – zdecydowanie nie.
Bez kalibracji na danych rzeczywistych nie wiadomo, czy system działa, czy tylko brzmi przekonująco.
Ten sam proces, inny model, inny wynik
Sprawdziłem też, jak bardzo wynik zależy od samego modelu. Ten sam zbiór 70 elementów, te same kryteria i ustawienia, zmieniał się tylko model oceniający: Gemma 4 31B, Qwen3.8 27B i jego wariant społecznościowy.
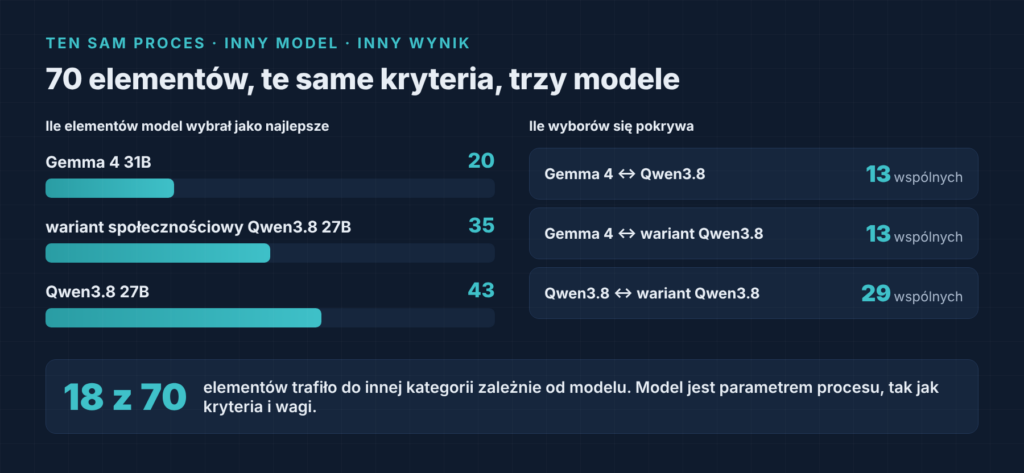
Gemma zakwalifikowała do najlepszych 20 elementów, wariant Qwen3.8 – 35, a Qwen3.8 aż 43. Każdy model stawia poprzeczkę gdzie indziej. Gemma pokrywała się z każdym z modeli Qwen tylko w 13 wyborach, dwa modele z tej samej rodziny w 29. A 18 z 70 elementów trafiło do innej kategorii zależnie od tego, który model oceniał.
Model jest więc parametrem procesu, tak samo jak kryteria i wagi. Po każdej jego zmianie, nawet na wyżej oceniany w rankingach, trzeba powtórzyć kalibrację. Duże różnice między modelami bywają też sygnałem, że kryteria są zbyt ogólne i każdy model wypełnia je po swojemu.
Gdzie zostaje człowiek
System niczego nie decyduje, tylko proponuje. Elementy tuż pod progiem trafiają do osobnej grupy „granica, do decyzji”, zamiast znikać. Każde porównanie ma zapisany krótki powód wyboru. Grupowanie czy przypisanie można poprawić w prostym pliku tekstowym, a system stosuje poprawki bez powtarzania całej pracy. Oryginały pozostają nienaruszone, a wszystkie dane pośrednie są zapisane, więc zawsze da się odtworzyć, dlaczego element trafił tam, gdzie trafił.
Gdzie ten wzorzec pasuje w biznesie
Deduplikacja, ocena według kryteriów, grupowanie, porównania parami, kalibracja i człowiek w pętli przenoszą się na wiele procesów: triage zgłoszeń serwisowych, wstępną kategoryzację reklamacji, porządkowanie dokumentacji szkód czy przegląd dokumentów przetargowych przed analizą prawnika.
Jeśli jednak przedmiotem oceny są ludzie – kandydaci do pracy, wnioskodawcy kredytowi – wchodzimy w obszar wysokiego ryzyka w rozumieniu AI Act, z wymaganiami dotyczącymi nadzoru, dokumentacji i jakości danych. Ten sam wzorzec da się zastosować, ale z pełnym procesem zgodności, a nie jako szybki pilotaż. Dobrze, że w całości działa lokalnie: w sektorach regulowanych to często warunek, żeby w ogóle zacząć.
Seria „Lokalna AI w praktyce”
- Co się psuje, gdy AI wychodzi z prezentacji do prawdziwej pracy
- Suwerenna AI: środowisko AI bez wysyłania danych do chmury
- Ile naprawdę daje lokalne AI? Wydajność i koszt
- Jeden model to za mało: portfel modeli AI
- Jak AI może przejrzeć tysiące elementów i nie zabrać człowiekowi decyzji (ten artykuł)
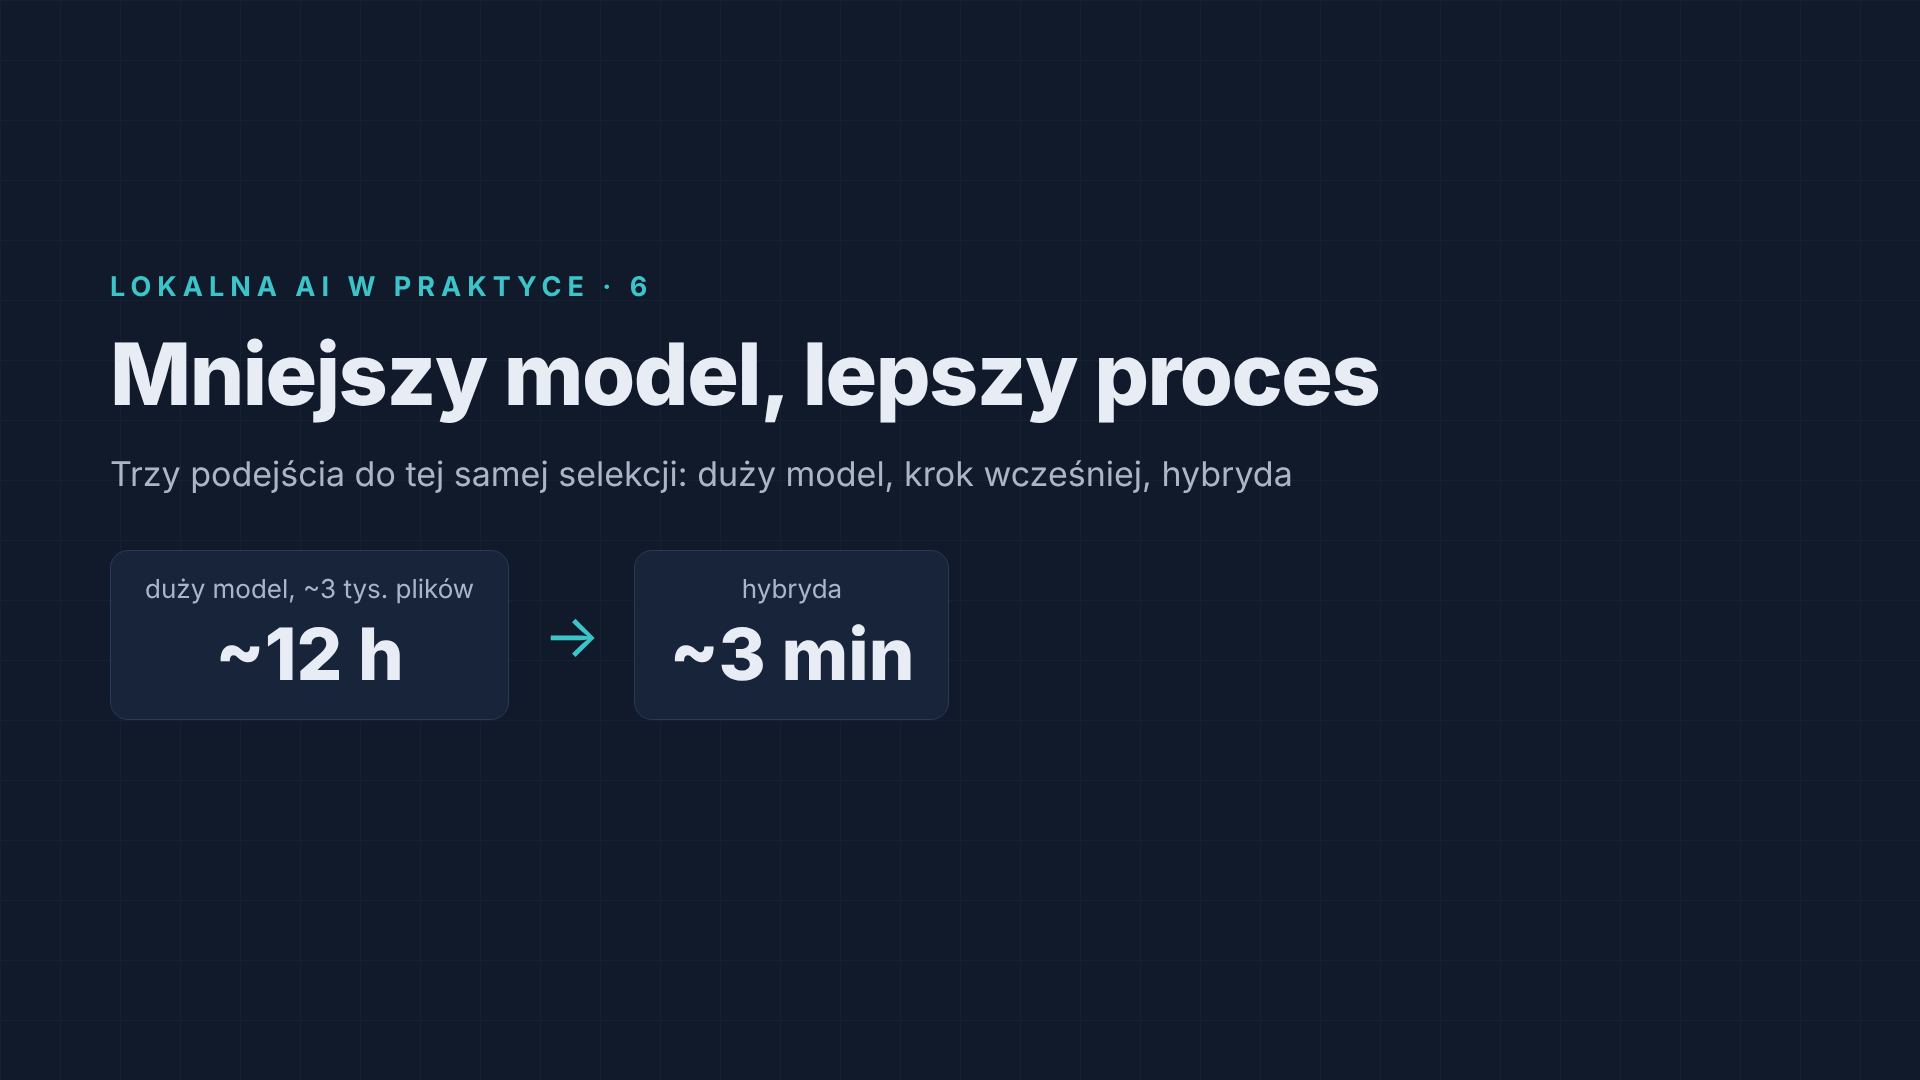
- Mniejszy model, lepszy proces: trzy podejścia do tej samej selekcji
Zastanawiacie się, czy i jak wdrożyć AI w organizacji, w której dane nie mogą wyjść poza własną infrastrukturę? Porozmawiajmy – zobacz też zakres usług.