Kiedy pojawia się problem „za dużo materiału do przejrzenia”, pierwszy odruch jest dziś prosty: weźmy największy model, na jaki nas stać, i niech oceni wszystko. Przeszedłem tę drogę na jednym konkretnym zadaniu: z partii kilku tysięcy obrazów trzeba wybrać kilka procent do dalszej pracy. Sprawdziłem trzy podejścia: duży model na końcu procesu, ten sam model przesunięty na początek procesu i hybrydę – mały model, klasyczne narzędzia i uczenie się na wcześniejszych decyzjach człowieka. Hybryda okazała się ponad dwieście razy szybsza, łatwiej się nią steruje, wymaga skromniejszego sprzętu, a na tym samym zbiorze częściej trafiała w rzeczywiste wybory. Poniżej opisuję, dlaczego, i co z tego wynika dla procesów biznesowych.
Problem
Jedna partia to od kilkuset do ok. 3 tys. plików, z których do dalszej pracy trafia kilka procent. Ręczny przegląd jest najbardziej czasochłonnym i najbardziej powtarzalnym etapem całego procesu. To typowa sytuacja: dużo materiału, mało decyzji, a każda decyzja wymaga spojrzenia człowieka.
Podejście 1: duży model na końcu procesu
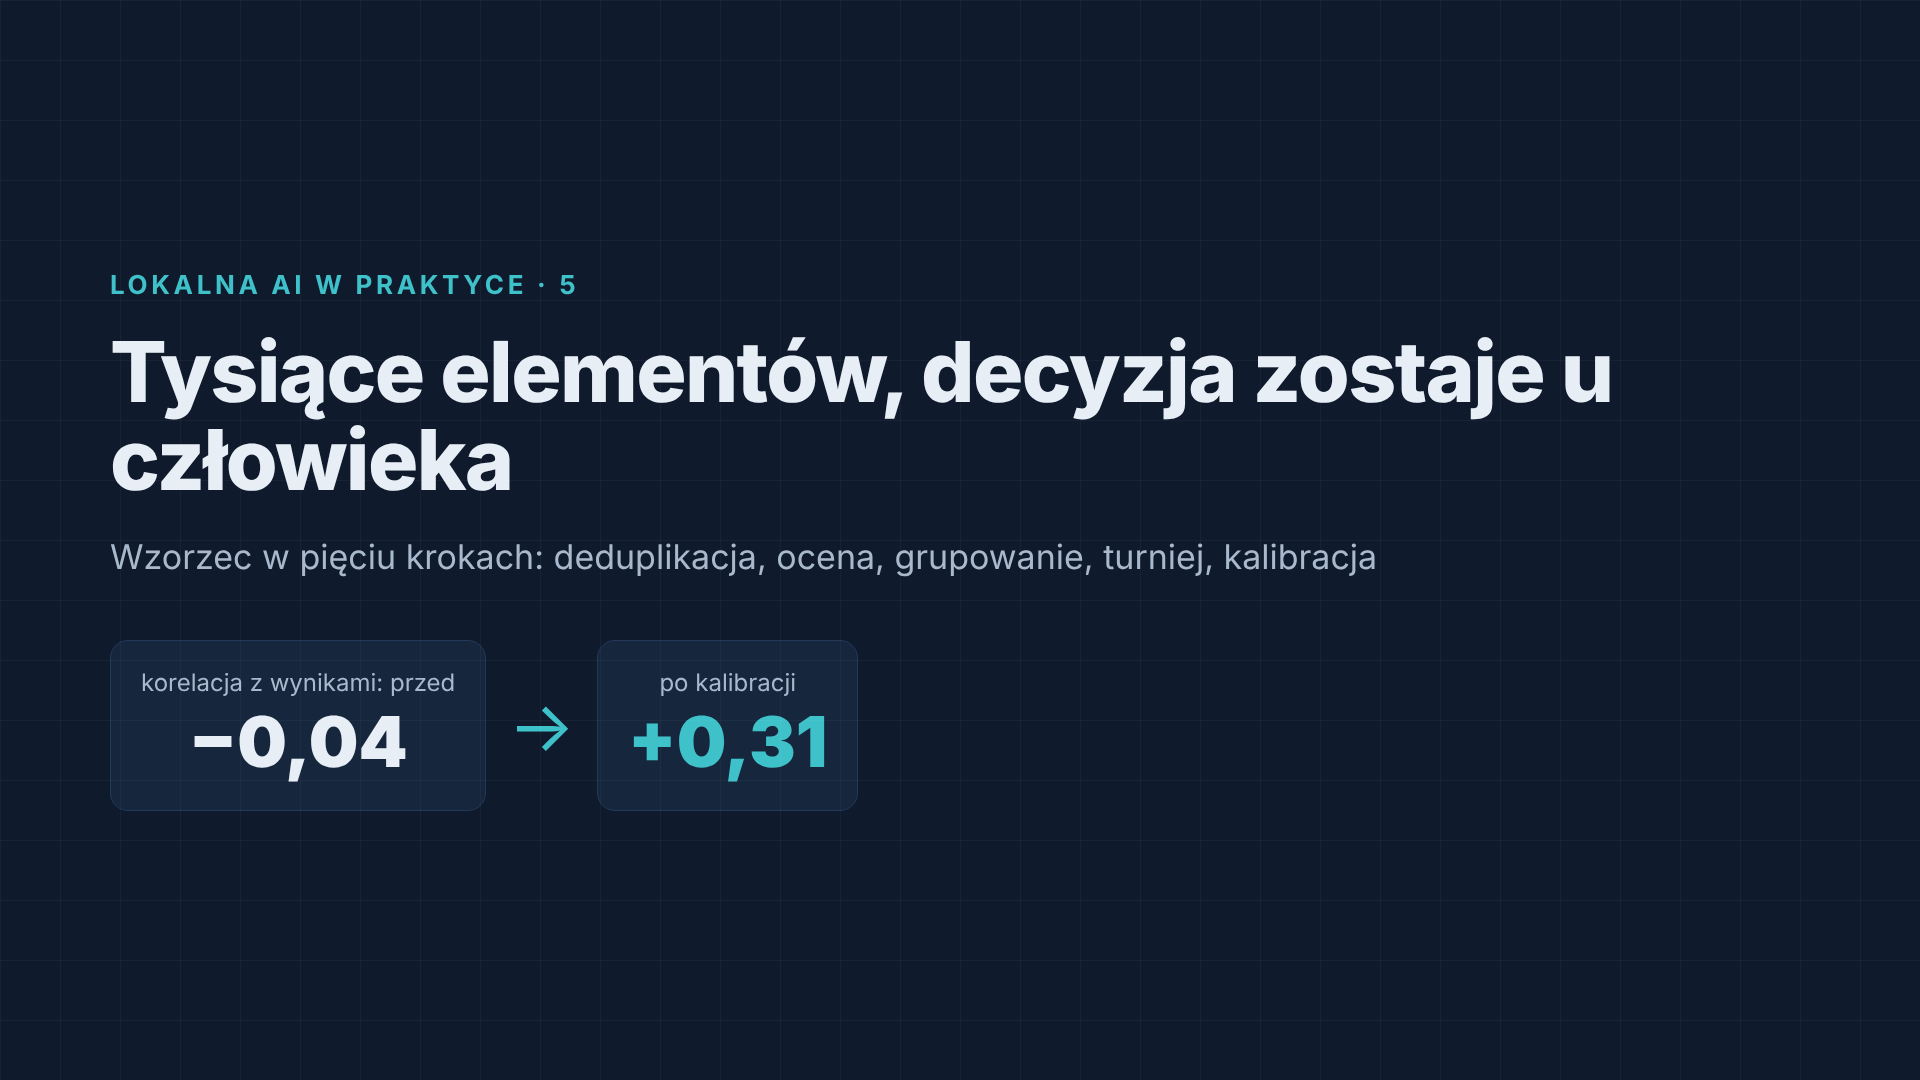
Pierwsza wersja oceniała materiał już po kosztownym etapie przygotowania. Model multimodalny o 27 mld parametrów dostawał każdy plik razem z opisanymi kryteriami, a potem rozstrzygał turniej porównań parami. Ten wzorzec opisałem szczegółowo w poprzednim artykule.
Po kalibracji działał: wyraźnie lepiej niż losowo wskazywał, gdzie patrzeć najpierw. Miał jednak dwie wady. Był wolny – ok. 9 godzin na partię, bo każdy plik to osobne zapytanie do dużego modelu, a turniej dokłada kolejne. I działał za późno: kosztowny etap przygotowania przechodziły wszystkie pliki, także te, które i tak miały odpaść.
Podejście 2: ten sam model, krok wcześniej
Naturalny ruch: przenieść selekcję przed przygotowanie. Ten sam model oceniał materiał źródłowy, a wynik trafiał od razu do narzędzia, w którym odbywa się dalsza praca.
Skuteczność znów była dobra, czas – nie. Zmierzony po fakcie wyniósł ok. 13,5–14 s na plik, powtarzalnie na dwóch partiach. Dla partii z 2936 plikami to ok. 12 godzin pracy maszyny. Każda zmiana kryteriów oznacza liczenie od nowa, a sprzęt musi pomieścić model z dziesiątkami gigabajtów wag.
Zmiana pytania: co tu naprawdę wymaga modelu?
Przełom nie przyszedł z lepszego modelu, tylko z rozbioru zadania na części i pytania przy każdej z nich, czy naprawdę potrzebuje „rozumienia”. Okazało się, że większość nie potrzebuje:
- Grupowanie powiązanych plików: wystarczą metadane i proste reguły.
- Odrzucanie elementów technicznie wadliwych: klasyczne algorytmy przetwarzania obrazu, szybkie i przewidywalne.
- Wykrywanie prawie identycznych plików: porównanie wektorów, bez żadnego zapytania do modelu językowego.
- Ocena, co jest warte wyboru: jedyna część, która wymaga uczenia. Ale nie potrzeba do niej wielkiego modelu, który rozumie wszystko – wystarczy, że nauczy się wcześniejszych decyzji człowieka.
- Decyzja ostateczna: człowiek.
Podejście 3: hybryda
Mały model wizyjny (ok. 0,4 mld parametrów, 1,5 GB) zamienia każdy plik w wektor, czyli liczbowy opis zawartości. Na tych wektorach działa najprostszy możliwy klasyfikator – regresja logistyczna – wytrenowany na historii: siedem wcześniejszych partii, 4383 pliki, z czego 1057 kiedyś wybrano. Etykiety były za darmo, bo historia decyzji już istniała. Nikt niczego nie opisywał ręcznie.
Pozostałe kroki wykonują klasyczne narzędzia, a człowiek zamiast pisać prompty ustawia kilka parametrów, np. jaką część materiału chce zobaczyć.
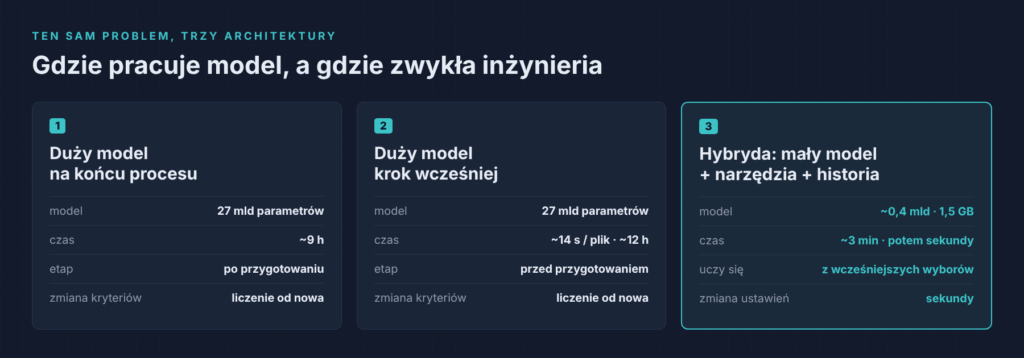
Czas: partia z 3734 plikami przy pierwszym uruchomieniu – 188 sekund, łącznie z liczeniem wektorów. Wektory trafiają do pamięci podręcznej, więc każde kolejne uruchomienie z innymi ustawieniami trwa sekundy. Zamiast 12 godzin – 3 minuty, a potem sekundy, na zwykłym laptopie.
A co z jakością?
Szybkość nie ma znaczenia, jeśli wynik jest gorszy. Porównałem więc oba podejścia na partii, której mały model nie widział przy nauce. Punktem odniesienia były rzeczywiste wcześniejsze decyzje człowieka: w części partii, którą przeszły oba podejścia (1765 plików), było ich 23.
Duży model oznaczył jako najlepsze 28% plików i trafił w 5 z 23 tych wyborów. Hybryda wskazała 21,6% plików i trafiła w 12 z 23, a przy tej samej liczbie wskazań co duży model – w 13. Miara trafności rankingu (AUC, gdzie 0,5 to losowanie) wyniosła 0,56 dla dużego modelu i 0,75 dla hybrydy. Duży model miał też problem opisany w poprzednim artykule: prawie wszystko oceniał wysoko, więc jego ranking słabo różnicował materiał.
Dwa zastrzeżenia, żeby nie przesadzić. To jedna partia i 23 wybory, czyli mała próba – wynik pokazuje kierunek, a nie prawo natury. I nie porównuję tu jakości modeli jako takich: mały model wygrał, bo uczył się na decyzjach człowieka, a duży oceniał według ogólnie opisanych kryteriów. To właśnie jest sedno: dopasowanie do konkretnego zadania dało więcej niż rozmiar modelu.
Dlaczego użytkownik woli hybrydę
Duży model jest sterowany opisem: piszę kryteria, poprawiam prompt, liczę od nowa i sprawdzam, czy pomogło. Hybryda uczy się z przykładów, czyli z decyzji, które i tak zapadają, a efekt zmiany ustawień widać po kilku sekundach. Podobny wniosek wyszedł mi w innej części tego samego procesu: główną pracę zrobił prosty, deterministyczny algorytm, a model językowy wyznaczył tylko cel.
Koszt: sprzęt, czas, utrzymanie
Sprzęt: duży model wymaga maszyny z dziesiątkami gigabajtów pamięci dla samego modelu. Hybryda zmieści się na zwykłym laptopie. Czas: kilkanaście godzin pracy maszyny zamienia się w kilka minut, więc selekcja przestaje być osobnym etapem, na który trzeba czekać. Utrzymanie: zmiana dużego modelu oznacza ponowną kalibrację kryteriów, a nowy trening klasyfikatora na świeżych wyborach trwa sekundy.
Nie oznacza to, że czas spędzony z dużym modelem był stracony. Pierwsze dwa podejścia pokazały, że problem w ogóle da się rozwiązać, nauczyły mnie, które cechy mają znaczenie, i dały punkt odniesienia do pomiaru. Duży model okazał się świetnym prototypem, ale słabym produktem.
Wnioski dla procesów biznesowych
Ten sam wzorzec widzę w wielu procesach biznesowych: klasyfikacja zgłoszeń, wstępna kategoryzacja dokumentów, triage reklamacji. Zamiast wysyłać każdy element do dużego modelu językowego, często wystarczą wektory z małego modelu, klasyfikator wytrenowany na historii decyzji organizacji i proste reguły tam, gdzie wystarczą. Historia decyzji, której firmy mają zwykle mnóstwo, jest wtedy lepszym nauczycielem niż najdłuższy prompt.
- Najpierw rozbierz zadanie na części i przy każdej zapytaj, czy naprawdę wymaga modelu.
- Duży model traktuj jako szybki prototyp i źródło wiedzy o problemie, a nie od razu jako rozwiązanie docelowe.
- Szukaj etykiet w historii: to, co ludzie już kiedyś zdecydowali, jest gotowym zbiorem uczącym.
- Mierz na danych, których model nie widział, i porównuj podejścia na tym samym zbiorze.
Większy model nie zawsze daje lepszy wynik. Często wystarczy dobrze zaprojektowany proces, w którym AI robi tylko to, czego nie da się zrobić prościej.
Seria „Lokalna AI w praktyce”
- Co się psuje, gdy AI wychodzi z prezentacji do prawdziwej pracy
- Suwerenna AI: środowisko AI bez wysyłania danych do chmury
- Ile naprawdę daje lokalne AI? Wydajność i koszt
- Jeden model to za mało: portfel modeli AI
- Jak AI może przejrzeć tysiące elementów i nie zabrać człowiekowi decyzji
- Mniejszy model, lepszy proces: trzy podejścia do tej samej selekcji (ten artykuł)
Zastanawiacie się, czy i jak wdrożyć AI w organizacji, w której dane nie mogą wyjść poza własną infrastrukturę? Porozmawiajmy – zobacz też zakres usług.